谈谈一次慢SQL优化,以及意外挖出来的MySQL执行引擎
最近在处理公司系统里配料任务模块的一段慢SQL,本来只是想按老套路加加索引、改改写法收工,结果盯着 EXPLAIN 里那一行 DEPENDENT SUBQUERY 看了半天,脑子里蹦出来一个问题:WHERE ... AND 到底是一行一行筛的,还是先给我拼出一张新表?这个问题一路把我拽进了火山模型、拽进了执行引擎和存储引擎的分工,最后又拽回来把这条SQL从 170ms 干到了 79ms。故写下这篇 BLOG,记录一下这趟”以为是调优、结果是探险”的经历。
起因:一段待优化的慢SQL
业务场景是配料任务里的”物料追溯”——扫码看这批物料具体是哪次工序用掉的。当时手上这条 SQL(脱敏后)长这样:
1 | SELECT |
盯着这一堆 AND 看的时候,突然冒出来一个挺基础但我从来没细想过的问题:
这些AND条件,到底是怎么被拿去筛选的?
如果是拿驱动表整表过一遍生成一张新的”驱动表”,那优化思路就应该是尽量把选择性好的条件往前放,先把这张子驱动表变小,再往下查;
但如果是逐行判断的,那也还是要把最”值钱”的(走得了索引的)条件排前面,查不中直接扔掉这一行,继续下一行。
这个突然冒出来的”猜想”,成了后面整条数据库执行引擎探索的引线——但别急,探险的部分留到后面,先把这条 SQL 按部就班地捋一遍。
第一步:用”每行代价”读懂这条SQL
优化的本质永远是:找出”会被重复执行 N 次”的东西。
这条 SQL 拆开看,其实就是:
1 | 扫描 materials_record r(受 del_flag=0 和 mn IN(10个值) 过滤) |
关键在子查询里的这一句:mn = r.mn AND process_uuid = r.process_uuid——它引用了外层的列,这叫相关子查询(correlated subquery)。和普通子查询有本质区别:
- 普通子查询(不引用外层列):只算一次,结果物化后复用。
- 相关子查询:外层每输出一个候选行,就要重新执行一次。MySQL 没有 subquery cache(MariaDB 才有),不会帮你去重。
所以总代价约等于 外层候选行数 × 单次子查询代价。这就是分析这条 SQL 的主线:这两个数分别是多少。由此我列了三个待验证的假设:
| 假设 | 说明 |
|---|---|
| H1 | 外层候选行数很大(mn 上没有可用索引 → 全表扫描 materials_record) |
| H2 | 单次子查询很贵(process_record 上没有 (mn, process_uuid, created_at) 的索引 → 每次都要扫一堆行 + filesort) |
| H3 | 两个 LEFT JOIN 的 material_pn_number 没索引 / 字符集不一致导致索引失效 |
注意 H1 和 H2 是相乘关系。哪怕单次子查询只要 1ms,外层 50 万行也是 500 秒——这类 SQL 慢得离谱基本都栽在这。
第二步:先看地形,把索引摸清楚
三张表各有多大、索引长什么样、字段类型和 collation 对不对得上——这一步经常被跳过,但很关键。
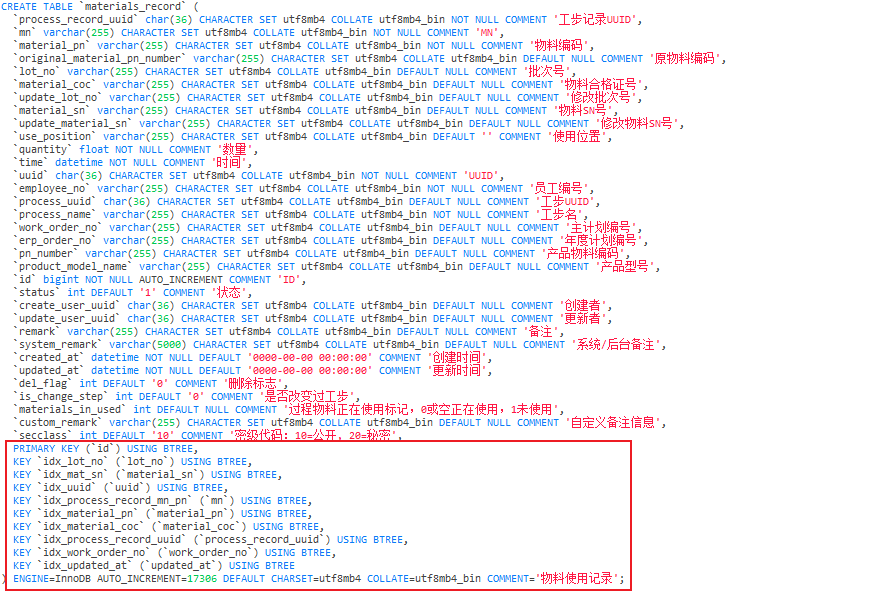
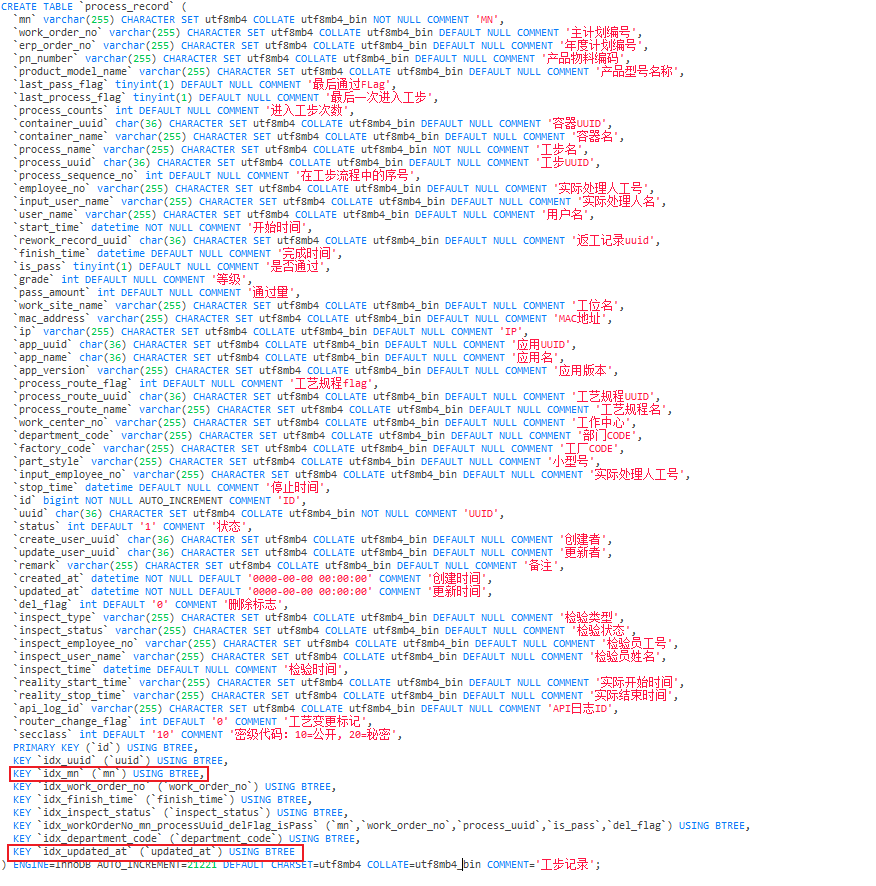
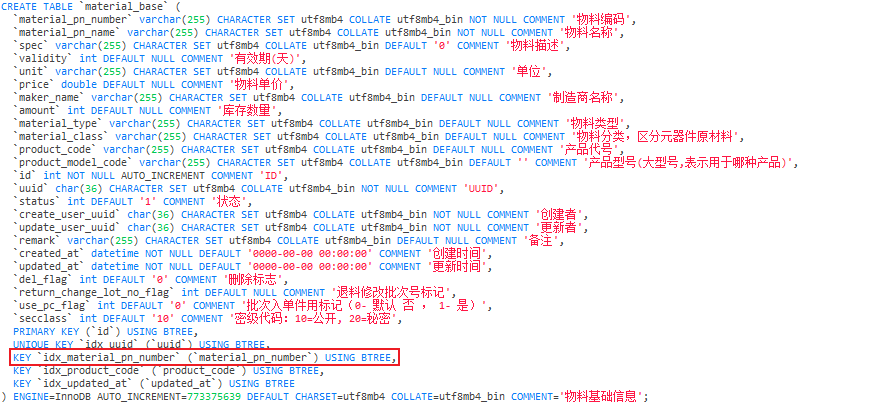
看完索引还得看一眼数据类型定义:
mn在两张表里是不是同一种类型和 collation。 如果一张是varchar(255) utf8mb4_general_ci,另一张是utf8mb4_0900_ai_ci,JOIN/关联条件上的索引会直接失效,MySQL 得逐行做字符集转换。mn是不是数值类型。 如果列是bigint而你传的是带引号的字符串,那还好(MySQL 会把常量转成数字);反过来,列是varchar而你传数字,会导致列被转换,索引全废。这里传的是引号字符串,列也确实是varchar,所以这条安全。
第三步:EXPLAIN,看”计划长什么样”
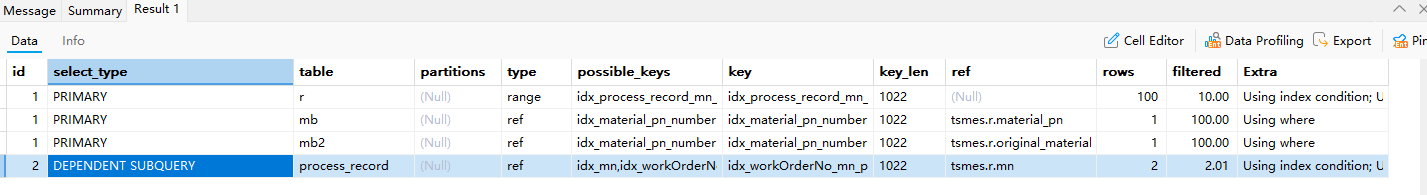
重点看这几列:
- **
select_type**:出现DEPENDENT SUBQUERY= H1/H2 这条主线成立,子查询确实被逐行重复执行了。 - **
type**:从好到坏大致是const > eq_ref > ref > range > index > ALL。这里外层r是range,还能接受;但process_record那行是ref,配合Extra里的Using filesort就麻烦了。 - **
key/possible_keys**:key为NULL就是没走索引;possible_keys有值但key是NULL,说明优化器认为走索引还不如全扫。 rows×filtered:优化器估算的扫描行数和过滤后剩余比例,不一定准,但数量级有参考价值。这里r表的filtered只有 10%,说明process_record_uuid = (子查询)这个条件根本没起到索引过滤的作用,是取回数据之后再逐行比对的。- **
Extra**:Using filesort出现在子查询行上 =ORDER BY created_at DESC没被索引满足,每次调用都要现排一次序。
两个致命信号摆在这了:相关子查询被逐行重执行,加上每次执行还要现排一次序。真正的坑,就藏在这两点背后。
插曲:WHERE...AND 到底是逐行筛,还是先生成新表?
看着 DEPENDENT SUBQUERY 这个词,前面那个突然冒出来的猜想又跳出来挠我:MySQL 到底是怎么”执行”一条 SQL 的?于是干脆把这条主线放一放,认真扒了一圈数据库执行引擎的底层逻辑。
省流结论:绝大多数情况下是一行一行、流式驱动(Row-by-Row);GROUP BY / DISTINCT / 排序无索引可用时,才会转成阻塞式批处理(Blocking)。
执行流程:以WHERE age > 18 AND city = 'Beijing'为例
- 引擎层读取:InnoDB 顺着索引/主键读取第 1 行。
- ICP 索引下推(若适用):
city在索引里的话,InnoDB 直接在索引树上判断,不符合就跳过,省去回表。 - Server 层过滤:InnoDB 把这一行交给 Server 层,Server 层再评估其余
AND条件。 - 决策:满足全部条件 → 立即向下游发送,不占内存保留;不满足 → 丢弃。
- 循环:读第 2 行……直到扫描结束。
整个过程像一条流水线,数据”流式”处理,非常省内存。只有出现无法流式完成的算子时,才会被迫在内存或磁盘生成中间表,比如:
GROUP BY/DISTINCT且无法利用索引顺序 → 需要先落地再去重/聚合ORDER BY且排序字段没有可用索引 → 走 Filesort,需要临时表/排序缓冲区- 复杂派生表/子查询(现代优化器会尽量合并、下推避免落地)
- 某些 JOIN 算法(如 Block Nested-Loop、Hash Join 的 Hash Table 阶段)
对应回最初那段 SQL:IN 子查询、时间范围条件本质上都是可以流式判断的谓词——MySQL 会尽量把它们下推、合并到主查询的行扫描过程中逐行判断,而不是先物化成一张临时表。这么设计的理由也很直接:千万级表如果先落地成新表,IO 和内存代价极高;流式处理下,第一条符合条件的记录可以立刻返回,不用等全表处理完。
火山模型(Volcano Model)
那这条”流水线”具体是怎么组织起来的?答案是数据库领域最经典的架构——火山模型,也叫迭代器模型(Iterator Model),由 Goetz Graefe 在 1990 年提出。核心思想:把 SQL 拆解成一棵由算子(Operator)构成的执行树,数据以”单条记录(Tuple)”的形式在树中流水线式传递。
拿一条最简单的 SQL 举例:
1 | SELECT name, age FROM users WHERE age > 18 ORDER BY age DESC; |
会被翻译成这样一棵算子树(自底向上组成,自底向上传递数据):
1 | [ Root: Result / Project ] <-- 4. 提取 name, age 输出 |
- 叶子节点:数据源读取算子,如
Table Scan、Index Scan,直接对接存储层。 - 中间节点:数据处理/转换算子,如
Filter、Join、Group By、Sort。 - 根节点:
Result/Project,整理最终字段返回给客户端。
理解算子树,就是读懂 EXPLAIN(尤其是 EXPLAIN FORMAT=TREE)的基础。
open-next-close:算子间的统一接口
所有算子(SeqScan、Filter、Join、Sort、Aggregate……)都实现统一接口:
1 | interface VolcanoOperator { |
控制流向下,数据流向上(Pull-Based / Demand-Driven)
火山模型”看似矛盾”实则解耦的核心设计:
- 控制流(Control Flow)→ 自顶向下(Pull):最顶层算子(如
Limit)调用子算子的next(),子算子为了满足需求,继续向下调用更底层算子的next()——按需索取,只有上层要数据时才触发下层执行。 - 数据流(Data Flow)→ 自底向上(Push/返回):叶子节点真正读取物理数据,像水流一样一条条被向上拉取,作为
next()的返回值逐级传递,经过过滤/连接/聚合,最终吐给客户端。
1 | [根节点: Client / Limit] |
比喻一下:顾客(根节点)喊”下一份”(next() 向下传递)→ 各工序依次向下要半成品 → 配菜员(叶子节点)取原料向上递给炒菜师傅 → 向上递给服务员(数据自底向上流动)。
走一遍 SELECT name FROM users WHERE age > 20 LIMIT 2;:
Limit向Filter要一条数据。Filter向SeqScan要数据。SeqScan读第 1 条(张三,18 岁)→Filter判断不满足 → 丢弃,继续要下一条。SeqScan读第 2 条(李四,25 岁)→ 满足 → 返回给Limit。Limit计数 +1,继续拉取,直到凑够 2 条后停止——后面几百万条数据根本不会被扫描/加载。
流式算子 vs 阻断算子
但不是所有算子都能”来一行吐一行”:
- 流式算子(Streaming Operators):如
SeqScan、Filter,来一行处理一行,立刻向上吐一行。 - 阻断算子 / Pipeline Breaker:如
HashAggregate、Sort,必须先把全部符合条件的数据吃进内存(建哈希表/排序),才能产出第一条正确结果,因此会阻塞流水线。
拿一个 GROUP BY + 聚合查询来看:
1 | SELECT department_id, AVG(salary) |
1 | [HashAggregate] <-- 根节点:GROUP BY + AVG(阻断算子) |
控制流自顶向下:HashAggregate.next() → Filter.next() → SeqScan.next();数据流则自底向上逐行返回:SeqScan 读一行给 Filter,Filter 判断不满足就丢弃再要下一行,满足就交给 HashAggregate 更新内存哈希表——但不向上产出任何结果,直到下层数据全部吃完。
这也正好解释了前面的结论:GROUP BY、ORDER BY(无索引可用时)之所以需要”临时表/中间结构”,正是因为它们是阻断算子,天生无法做到边读边吐。
优缺点
优势:解耦与扩展性好(新增算子不影响其他算子);内存占用低(不需要一次性缓存整张表);支持流式输出(客户端不用等全部算完就能拿到第一批结果,利于分页场景)。
劣势(现代硬件下的瓶颈,多见于 OLAP 场景):虚函数调用开销大(亿级数据可能触发几十亿次 next() 调用,CPU 指令缓存/分支预测不友好);无法充分利用 CPU Cache 与 SIMD(逐行处理打乱缓存局部性,无法向量化)。
针对这两点,现代分析型引擎有两条改造路线:向量化执行让 next() 一次返回一批(如 1024 行),把虚函数调用开销摊薄到整批上,顺带能用 SIMD(ClickHouse、DuckDB);代码生成(JIT / Push 模型)则直接打破算子边界,把整棵算子树编译成一段紧凑机器码循环(Spark SQL Whole-Stage CodeGen、Hyper)。不过这些主要服务于 OLAP 场景;MySQL 日常的 OLTP 查询仍以经典火山模型为主。
执行引擎与InnoDB的分工
顺带把”执行引擎”和”存储引擎”这两个经常被混着说的概念也理清楚了:执行引擎负责”计算与流程控管”,InnoDB 负责”数据存取与持久化”。
| 维度 | 数据库执行引擎(Server 层) | InnoDB(存储引擎层) |
|---|---|---|
| 主要职责 | SQL 逻辑执行、算子调度、Join、Sort、Filter | 数据物理存储、索引维护、事务、锁、崩溃恢复 |
| 比喻 | “指挥官/包工头”:规划步骤,协调资源 | “仓库管理员”:按规矩安全存取物资 |
| 通用性 | 数据库通用,不依赖具体存储引擎 | 可插拔,MySQL 还可选 MyISAM、Memory 等 |
1 | [ 客户端 ] |
执行引擎管的是执行模型(Iterator/向量化)、表达式计算、关系代数算子(Nested Loop Join、Hash Join、Sort-Merge Join、Aggregate);InnoDB 管的是表空间/段/页、B+ 树索引、Redo Log(原子性/持久性)、Undo Log(回滚/MVCC)、行锁/Next-Key Lock、Buffer Pool——完全不同的分层,靠 handler API 协作。
这一圈下来,DEPENDENT SUBQUERY 到底意味着什么就再清楚不过了:它是一个没法被流式判断、必须为外层每一行都单独 open/next/close 一遍的子树,而且每次 open 还带一次 filesort。原本以为的”一条 SQL、一次往返”,本质上是数据库在帮我偷偷执行了几千上万次的小查询。
回到正题:把这条SQL治好
绕了一圈回来,问题的轮廓已经很清楚了。
根因一:相关子查询 = SQL 内部的 N+1
大家熟悉的 N+1 通常是 Java 循环里调 Mapper。但相关子查询是写在 SQL 里的 N+1,隐蔽性极强——它看起来”只有一条 SQL、只有一次数据库往返”,很容易被误认为已经是优化过的写法。
识别特征很明确:子查询的 WHERE 中引用了外层表的别名(mn = r.mn),并且带 ORDER BY ... LIMIT。 在这次实测的数据集下,200 个 MN 命中的 materials_record 候选行约 1.2 万行,也就是说子查询被执行了约 1.2 万次,每次都附带一次 filesort。
根因二:= (子查询) 谓词用不了索引
materials_record 上其实存在 idx_process_record_uuid 索引(基数 4,419),但旧写法完全用不上它。原因在于 r.process_record_uuid = (SELECT ...) 的右值直到运行时逐行才能确定,优化器没法把它当成索引查找的驱动条件。计划中 r 表的 filtered 只有 10%,说明这个条件被降级成了取回数据后的行过滤(post-filter),而不是索引定位。
重构思路:把DB不擅长的事挪到应用层
业务语义其实是一次典型的 top-1-per-group(分组取最新一条):对每个 (mn, process_uuid) 组合,取 created_at 最大的那条 process_record,再取出挂在该 process_record.uuid 下的所有 materials_record。
思路就是把 DB 不擅长的 top-1-per-group 移到应用层,只让 DB 做它擅长的有索引支撑的过滤与一次性批量排序:
1 | ① 一次批量查询:按 mnList 捞出全部 process_record(只取 4 列,ORDER BY created_at DESC) |
关键转换就一句话:把不可索引的谓词变成可索引的常量列表。
1 | r.process_record_uuid = (相关子查询) → r.process_record_uuid IN (常量列表) |
落到代码上,Mapper 接口拆成两个方法:
1 | public interface MaterialsRecordMapper extends BaseMapper<MaterialsRecord> { |
Service 层三步走:
1 |
|
几个值得说道说道的点:
ORDER BY+putIfAbsent,8 行 Java 实现窗口函数语义。 SQL 侧已经按created_at DESC排好序,遍历时第一次遇到某个(mn, processUuid)的记录必然是最新的,putIfAbsent天然实现”只保留最新”,语义精确等价于ROW_NUMBER() OVER (PARTITION BY mn, process_uuid ORDER BY created_at DESC) = 1,而且一次遍历、一个 Map、零中间集合,比Collectors.groupingBy(..., maxBy(...))省不少分配开销。- 只取 4 列的窄列查询。
ProcessRecord实体有 30+ 个字段,去重这一步只需要uuid, mn, process_uuid, created_at,网络传输量和结果集堆占用相差一个数量级。批量拉取场景下,SELECT *是最昂贵的坏习惯。 - 三层空判定,第三层不是形式主义。 若
latestMap为空还去调 Mapper,MyBatis 的<foreach>会生成IN ()——语法非法的 SQL,直接抛异常。这是把单体 SQL 拆成多步查询后必须付出的防御成本:每个中间结果都可能为空,每个空都得挡住。
效果:EXPLAIN和耗时的对比
重构前的关键节点:
1 | select_type = DEPENDENT SUBQUERY ← 逐行重执行 |
重构后的关键节点:
1 | select_type = PRIMARY ← 无 DEPENDENT SUBQUERY |
DEPENDENT SUBQUERY 节点彻底消失,idx_process_record_uuid 被启用——这是这次优化最直接的结构性证据。
实测拿 materials_record 中用料记录数最多的 200 个 MN 压测(结果集 11,828 行,测量时已扣除链路 RTT):
| 方案 | 服务端耗时 | 往返次数 |
|---|---|---|
| 重构前(相关子查询) | ~170 ms | 1 |
| 重构后(两步 + Java 归约) | ~79 ms | 2 |
提速约 2.2 倍,服务端耗时下降约 54%。 单个极端 MN(3,300 条用料记录)的场景更夸张:旧版对这一个 MN 就要执行 3,300 次子查询,新版只需 14 次索引定位,耗时从 ~48ms 降到 ~21ms。语义上,三种实现(重构前、重构后、备选的 ROW_NUMBER() 单条 SQL 写法)在同一测试集上返回行数完全一致,都是 11,828 行,可以确认没有改变查询语义。
后来还专门做了一轮新老版本的一致性验证——挑了 5 个真实工单,串行调用新旧两套接口,把响应结果做多重集摘要比对,量和值都能对得上,才把这次重构收尾。
复盘:这次能复用的经验
- 识别”看不见的 N+1”。 判据:*子查询 WHERE 中出现外层表别名 +
ORDER BY ... LIMIT*。它只有一条 SQL、一次往返,极易被误判为已优化。看到这个组合就该用EXPLAIN确认是不是DEPENDENT SUBQUERY。 - 把不可索引的谓词改造成可索引的常量列表。
col = (相关子查询)优化器用不了索引;col IN (常量列表)可以直接 range scan。这是这次提速的核心机制,适用面远超这一个案例。 - top-1-per-group 是关系模型的软肋,考虑上移到应用层。 当分组结果集在数千行量级时,应用层
HashMap去重是纯内存的 O(n) 操作,比数据库的排序 + 磁盘 IO 便宜若干数量级。让 DB 做有索引支撑的过滤和批量排序,让应用做哈希与集合运算,按各自长处分工。 - 批量拉取务必窄列查询——30+ 字段的实体只取真正需要的几列,传输和内存能差一个数量级。
- 拆成多步查询后,每个中间结果都必须判空——尤其是要喂给
<foreach>的集合,空集合会生成非法的IN ()直接抛异常。
当然也留了几个没有立刻处理、但记在心里的尾巴:READ-COMMITTED 隔离级别下两次查询不在同一快照,理论上存在极小的时序窗口;IN 列表规模没设上限,mnList 一旦变大需要考虑分批;如果同一分组下 created_at 完全相同,取哪条是不确定的。这几点在当前数据规模下影响都不大,但值得写进代码注释里防止以后被人当成强一致性来用。
写在最后
本来以为就是一次很平常的”加索引、改写法”的调优,结果因为多问了一句”这些 AND 到底是怎么被拿去筛的”,把自己送进了火山模型的兔子洞。但也正是这一圈绕远路,让我对 EXPLAIN 里 DEPENDENT SUBQUERY 这个词有了肌肉记忆般的警觉——以后再看到”子查询引用外层别名 + ORDER BY LIMIT“这个组合,脑子里会自动报警。
技术上的问题,有时候真的值得多问一句”为什么”,哪怕看起来跟眼前要解决的事情没什么关系。