拆解Matt Pocock的diagnosing-bugs
最近想写一套自动修复bug的工作流去自动修复p2以下的工单,仔细想了一下: 自动化的前提是有个一个科学的手动化为基础的,然后再把手动人工决策的部分交给ai自动去判断。所以,得先仔细看看目前开发流的一些细节,深度理清楚各个skills与mcp之间的配合,然后再想办法改造成自动化工具。
查了下 claude code当中skills的触发次数,与目标相关且最为重要的之一就是这个 diagnosing-bugs 了。
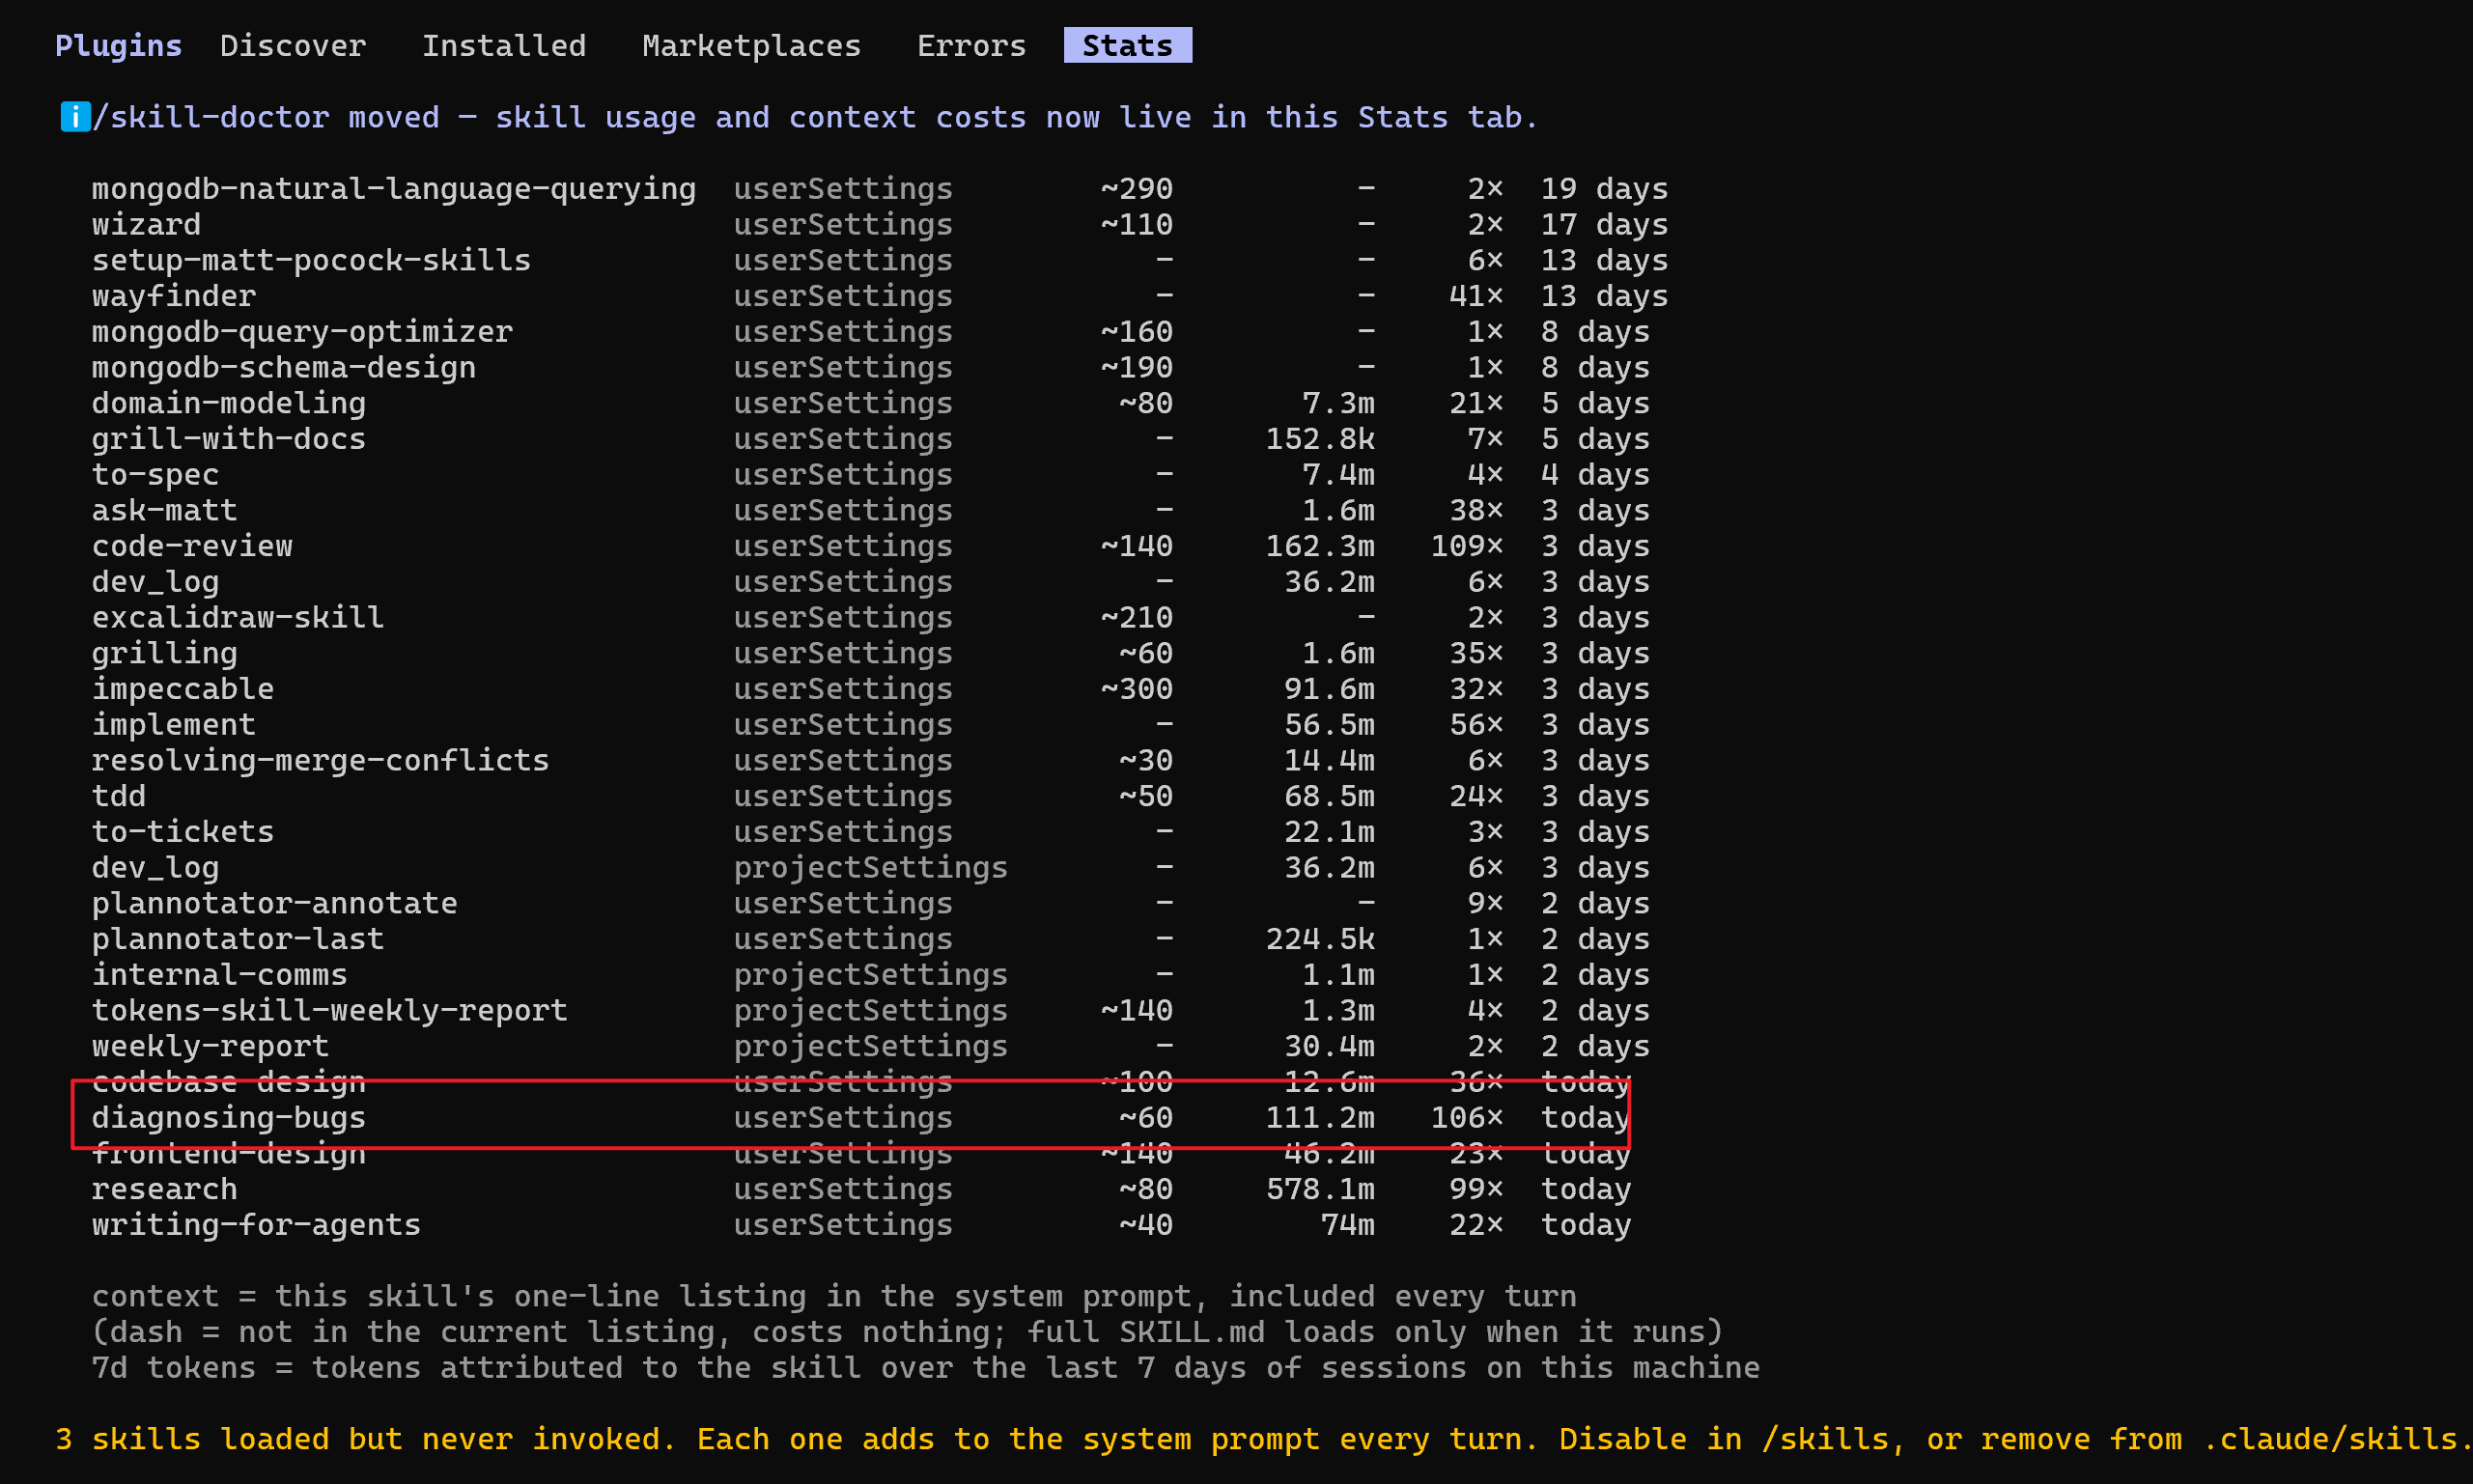
一句话描述这个skill的作用:
强制 agent 在提出任何原因假设之前,先造出一条能在这个 bug 上变red、修复后变green、几秒内跑完、且能无人值守执行的feedback loop,然后用这条feedback loop驱动复现、假设、验证和回归的整个调试过程。
六大核心步骤
Phase 1 - 构建反馈回路 feedback loop
构建Feedback loop是ai改代码最重要的一道工序,ai没有具体诊断bug的能力,它只能从bug的现象当中去猜修复的位置,所以需要构建一套科学、可观测、可复现的bug评测体系,feedback loop的成功构建分为4个指标:
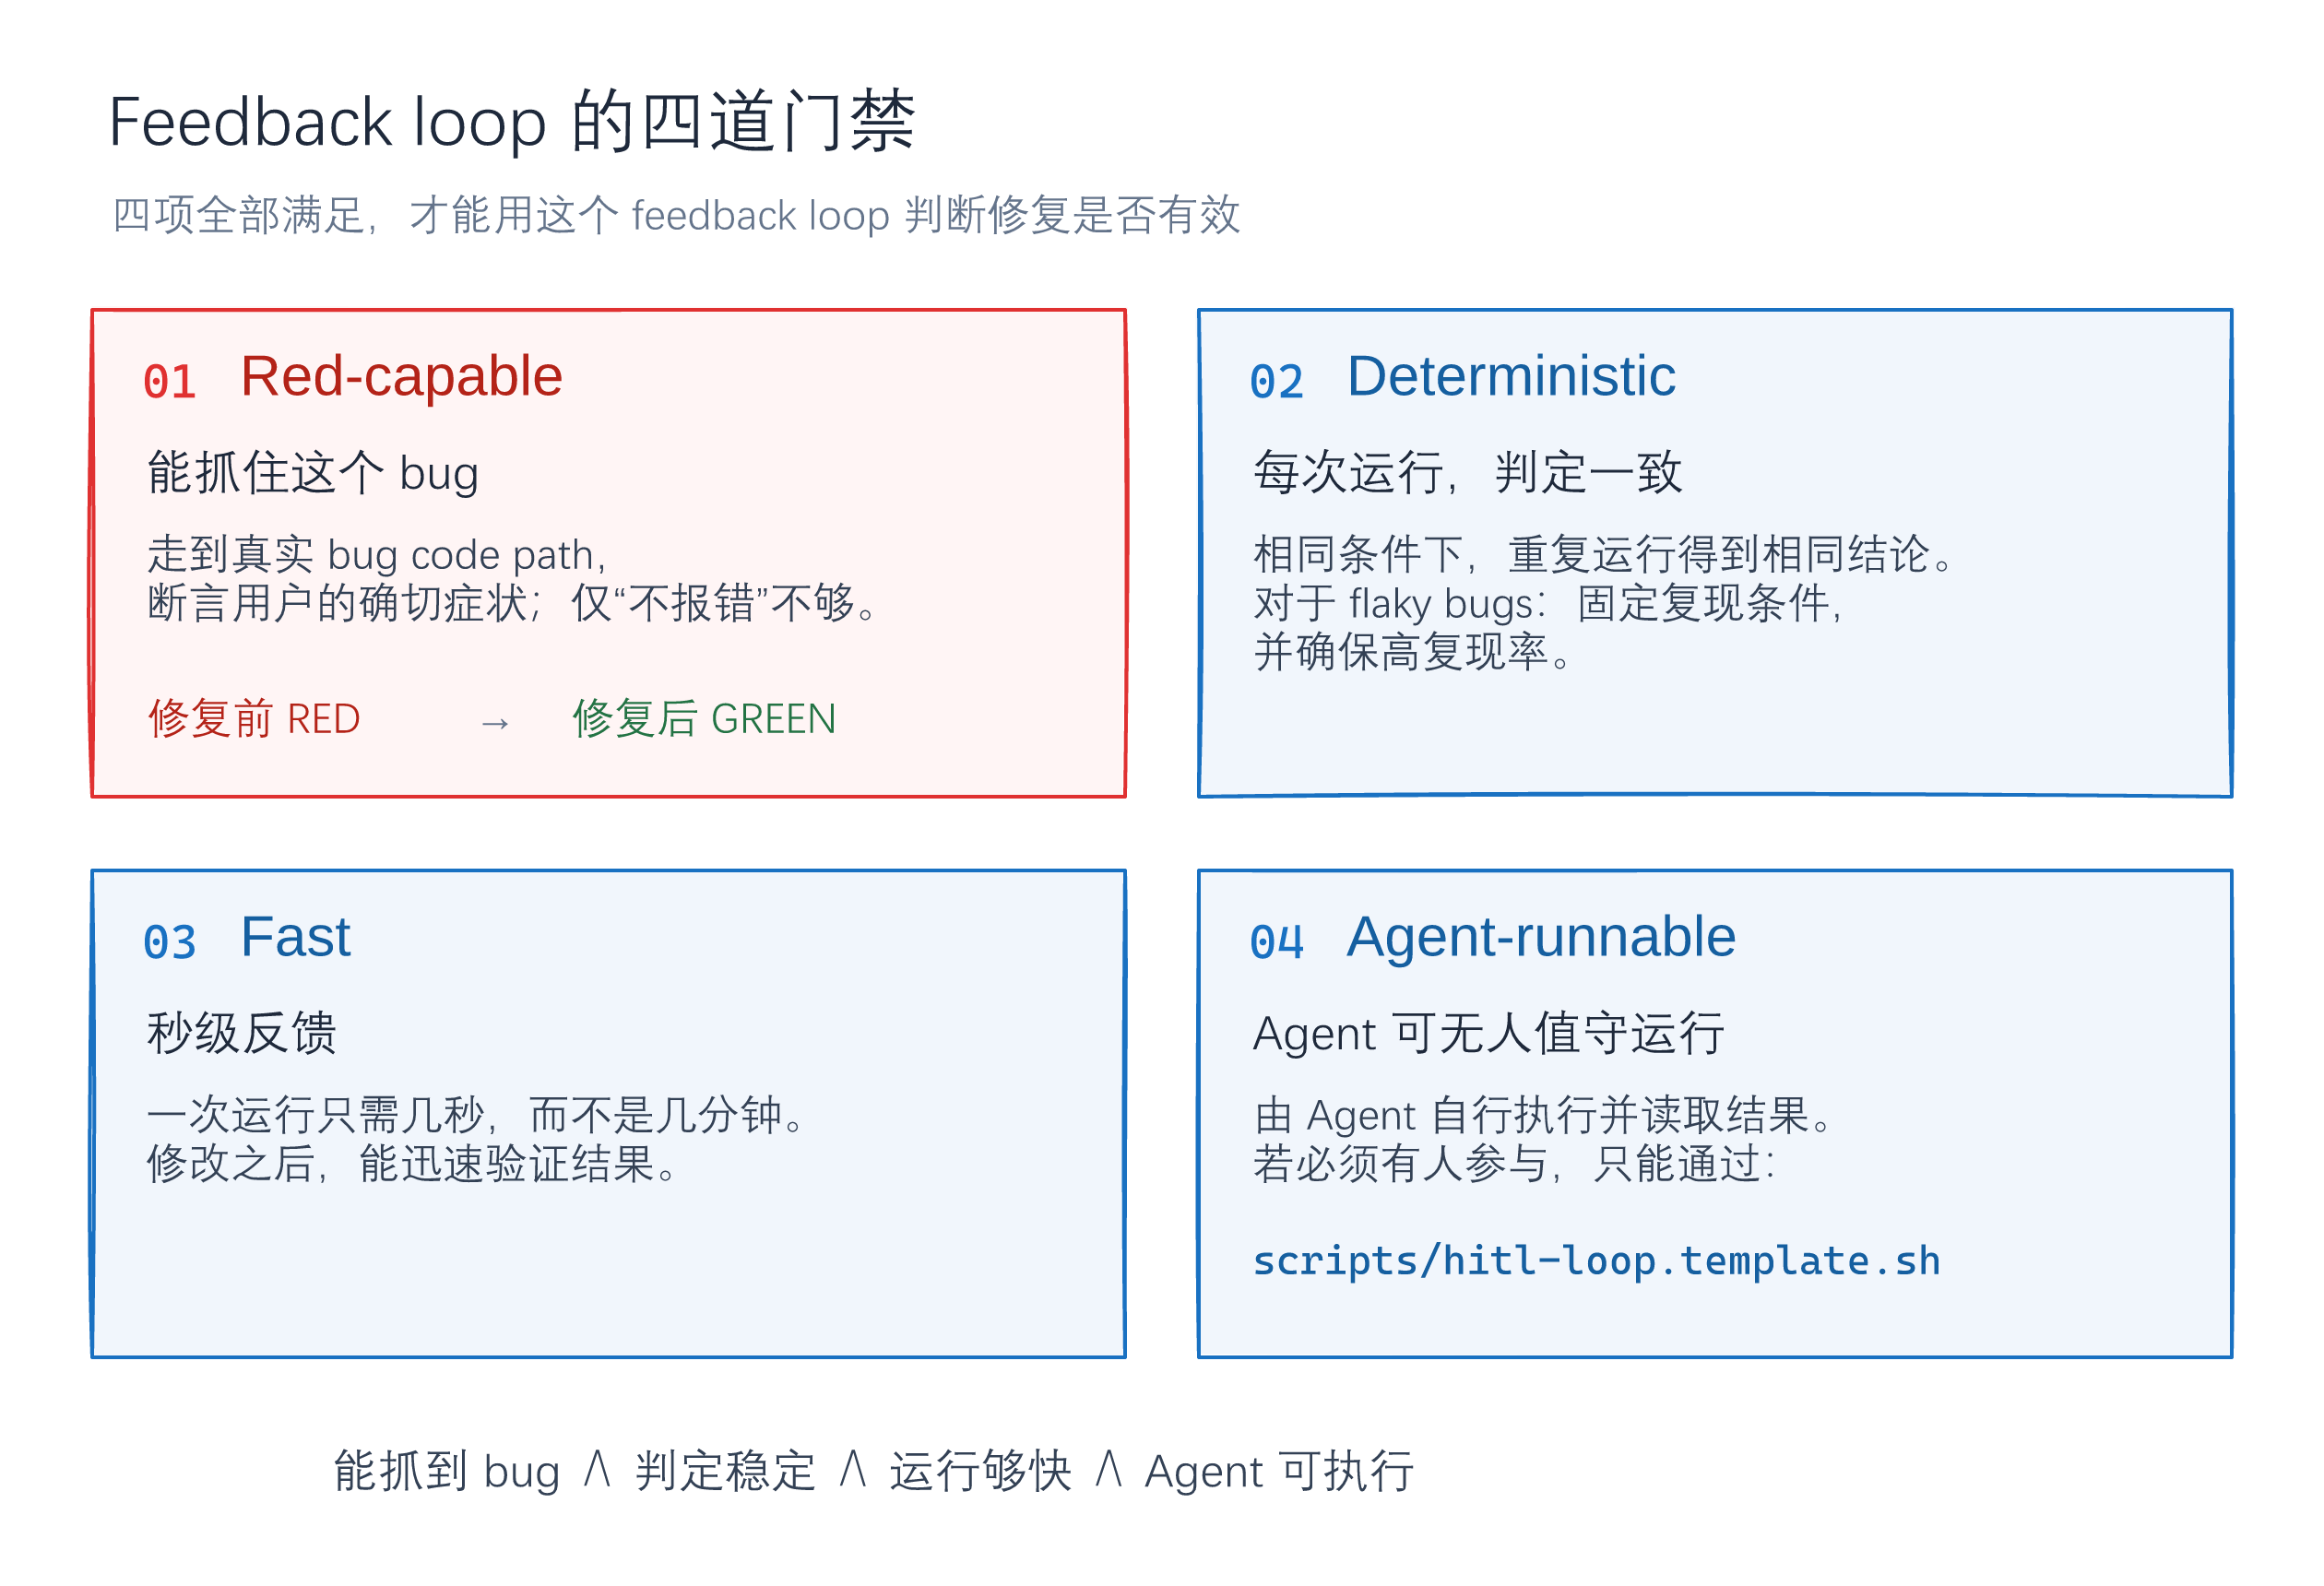
这四个指标具体怎么理解呢?
- Red-capable:它得真的能抓住这个bug。比如问题是重复创建订单,就应该检查一次操作之后到底产生了几笔订单,光看接口返回200肯定不够。
- Deterministic:相同条件下,结果应该稳定。涉及时间、随机数、外部请求的地方,尽量把这些影响因素固定下来;如果是并发一类偶发bug,就先想办法提高并记录复现率。
- Fast:一次验证最好几秒就能结束。每改一行都要等上几分钟,后面想反复排查,成本就太高了。
- Agent-runnable:ai能自己执行并拿到结果。真有绕不过去的人工操作,也得把步骤和结果收集方式固定下来,不能每次都靠人临场发挥。
实现方式可以是一个 failing test,也可以是 curl、CLI、浏览器脚本,甚至临时搭一个只跑相关逻辑的 harness。具体用哪个,要看什么方式能触发这个bug。
本质上,feedback loop的作用,是在不断做实验:提出原因、改变一个条件、观察结果,red 是否变 green;变了则可能是bug原因之一,再具体去试验原因…
Phase 2 - 复现 + 最小化 reproduce +minimise
有了反馈回路,然后就得实际跑起来,看着它变 red。但这里得确认一下:现在看到的失败,真的是最开始要解决的那个问题吗?比如原本是订单重复创建,结果脚本因为鉴权失败直接返回401,这也算“红了”,但根本没有走到出问题的地方。所以,要把具体的错误输出、触发条件记录下来,多跑几遍,确认复现的是同一个bug。
确认之后,就开始做减法。输入数据能不能少一点?调用链能不能短一点?哪些配置、操作步骤其实跟这个问题没有关系?每次只去掉一部分,再跑一遍 feedback loop,看bug还在不在。在,就说明这部分可以先拿掉;不在,就得把它放回来,看看它为什么会影响结果。
Phase 3 - 形成假设 Hypothesise
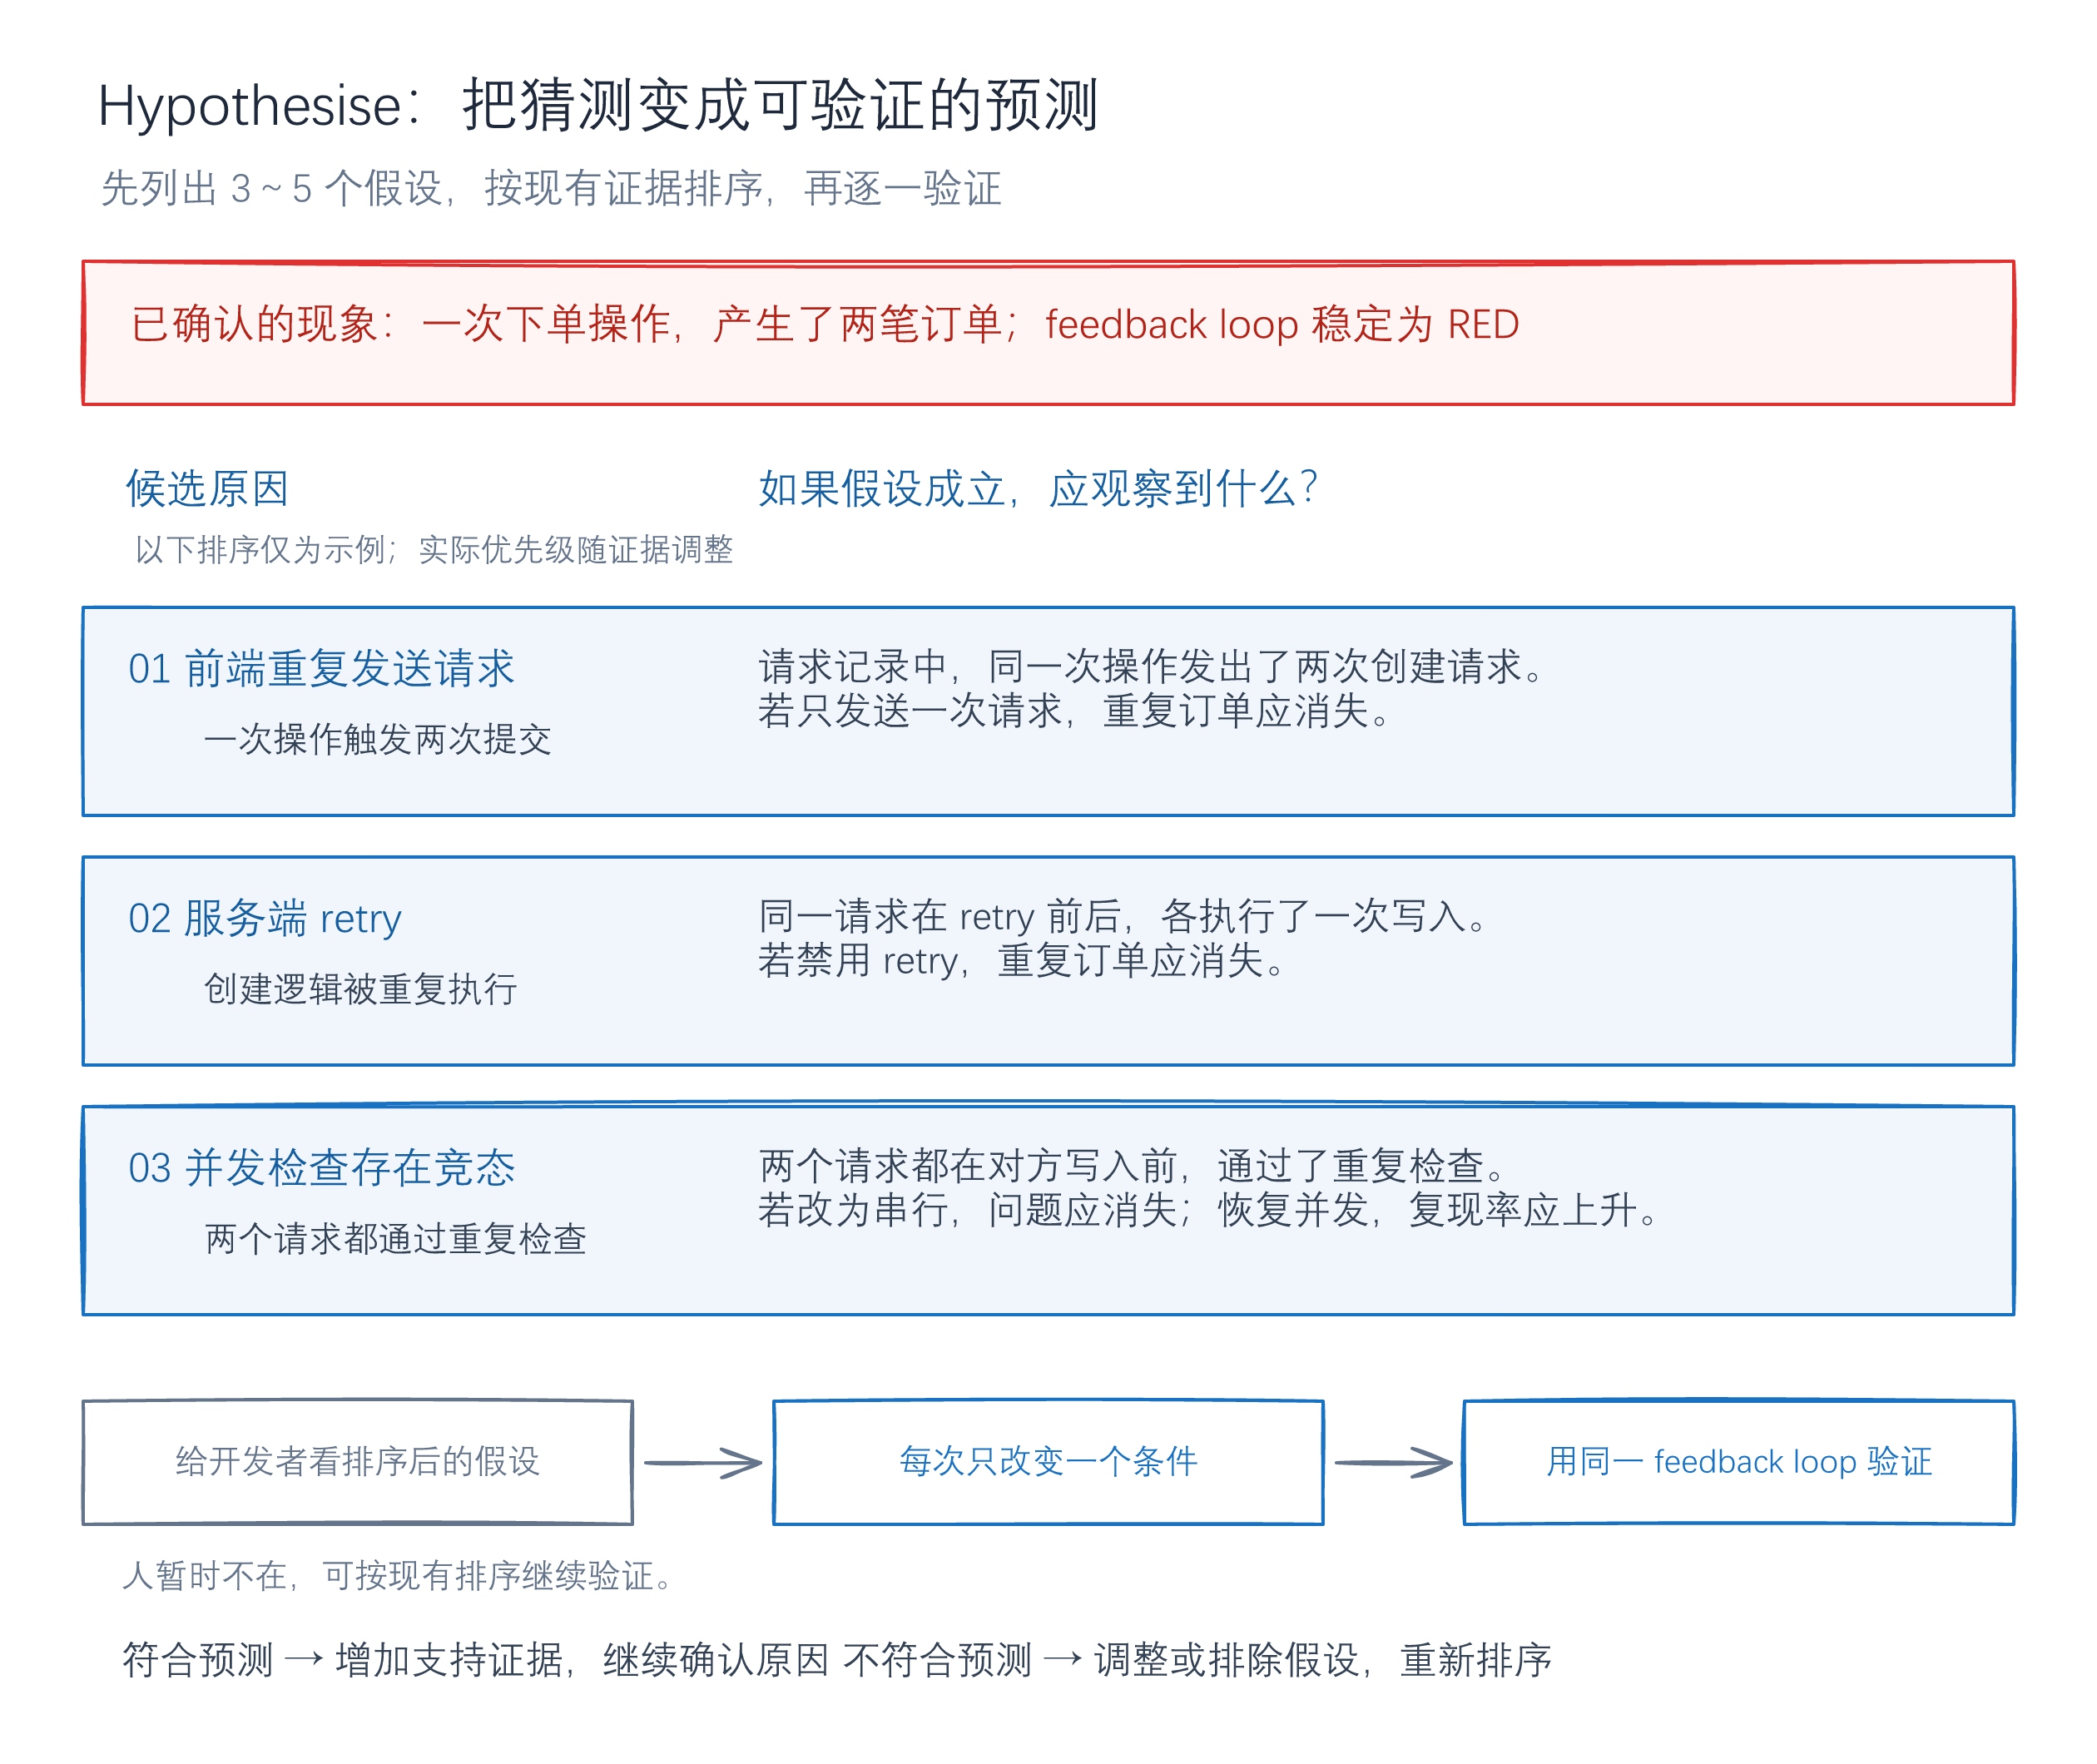
OK,现在有了稳定的现象,也缩小了范围,可以开始想“为什么”了。diagnosing-bugs要求列出 3~5个有优先级的假设,这点很有意思,从架构上弥补了: ai很容易看见一段可疑代码,就顺着第一个看起来合理的解释一路改下去,改完发现没用,再继续往上补的死循环……所以,先把几个可能的原因摆出来,并且每一个都得能验证。
Phase 4 - 插桩 Instrument
何为“插桩”?说白了,就是在程序运行的关键位置放一些观察点,看看实际执行过程是不是符合刚才的猜测。能用 Debugger / REPL 直接检查就先用,实在不方便,再加有针对性的 log。
比如怀疑两个请求都通过了重复检查,那就去观察这两个请求的执行顺序、检查结果和写入时机。每一个观察点都应该对应前面某个假设。把整个项目的 log 全开了,看着终端刷屏,信息是多了,但真正要找的东西也被淹没了🤯。
然后,每次只改变一个条件,跑同一套 feedback loop,看结果是否符合预测。不符合,就调整或者排除这个假设,再检查别的可能。临时 log 统一加一个独特的前缀,比如 [DEBUG-a4f2],后面方便一次性找出来清理。如果排查的是性能问题,则优先建立耗时基线,用 profiler、query plan 等工具找瓶颈,再用 bisection 缩小范围,大量打印 log 本身就可能影响测量结果。
Phase 5 - 修复 + regression test
原因确认之后,终于可以动手改了。但diagnosing-bugs把 regression test 放在修复之前:先把刚才的最小复现变成一个会失败的测试,亲眼看着它失败,再改代码,再看它通过。
Phase 6 - 清理
最后执行清理步骤,排查过程中加的临时 log、用来复现的脚本、临时改过的配置,都会被清理掉。
diagnosing-bugs 修复实践
项目分配权限bug
6大核心步骤过了一遍,拿一个实际的bug试一下:用户已经被授权为管理员,但找不到“项目管理”和新增项目的入口。这里先不展开具体的业务逻辑,主要看看agent接到任务之后,是怎么一步步往下跑的。
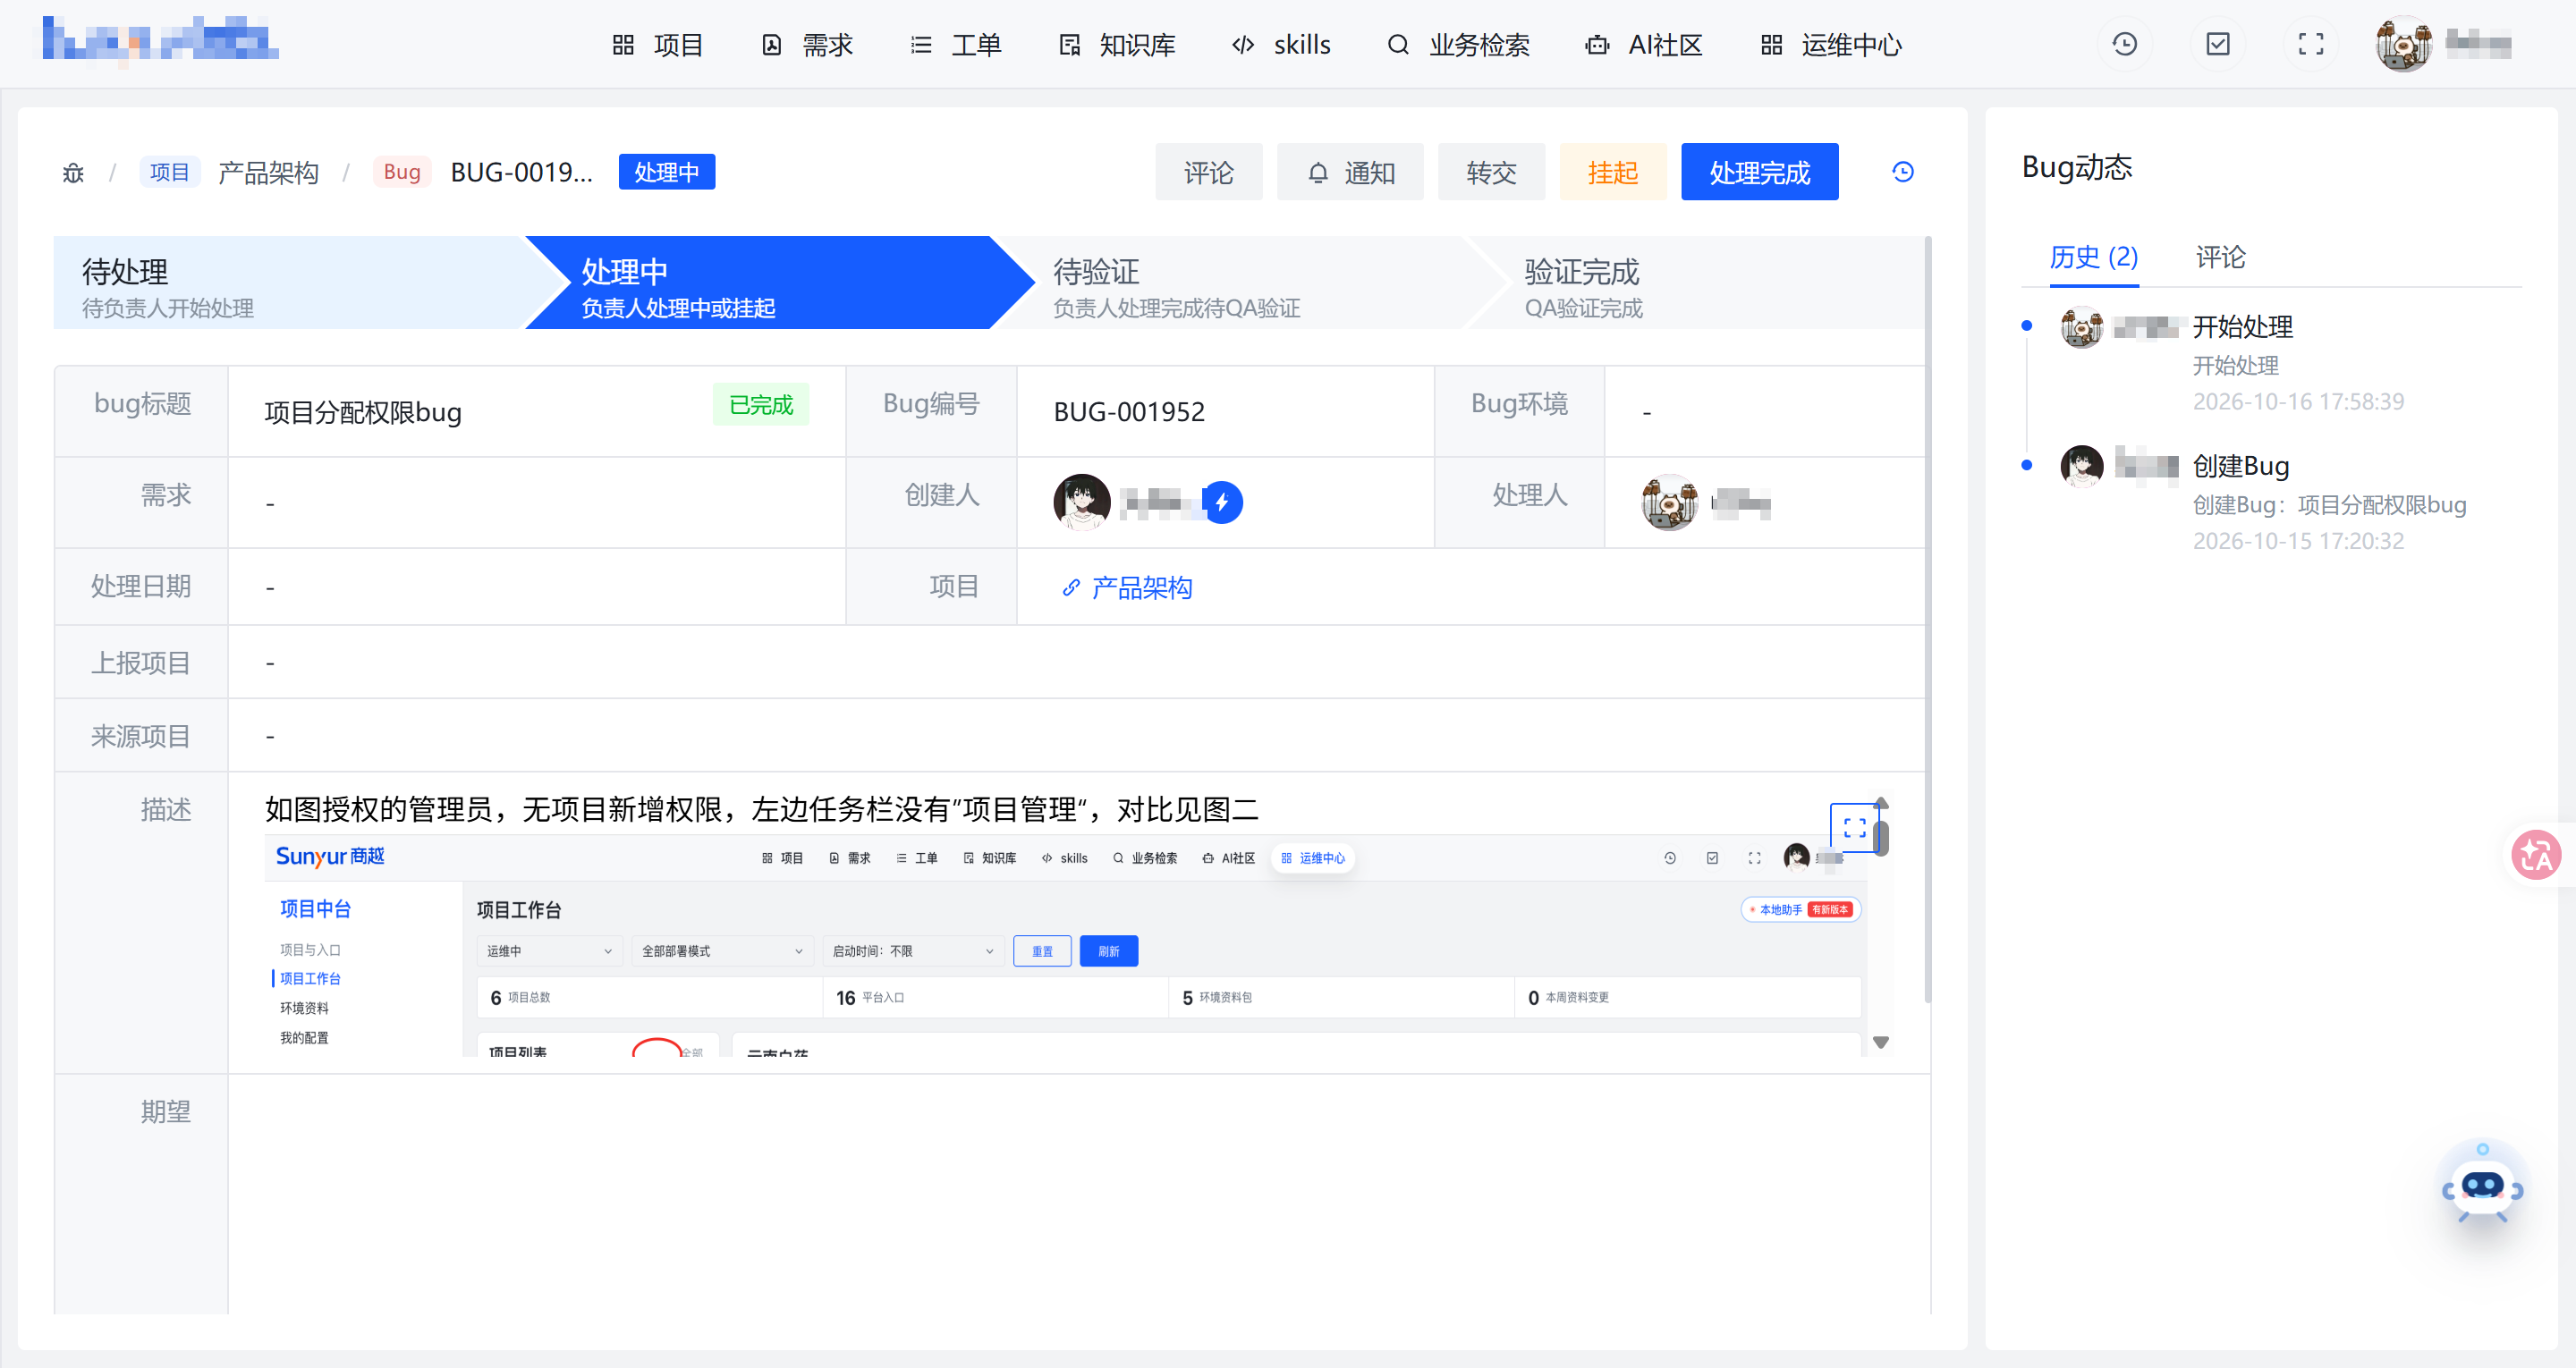
获取bug信息,定位相关文件
我给agent的输入就一句:BUG-001952 帮我查一下这个bug的原因。然后,diagnosing-bugs 被触发,agent通过 sy_pms MCP 查询bug详细信息,再去找本地代码和架构文档。
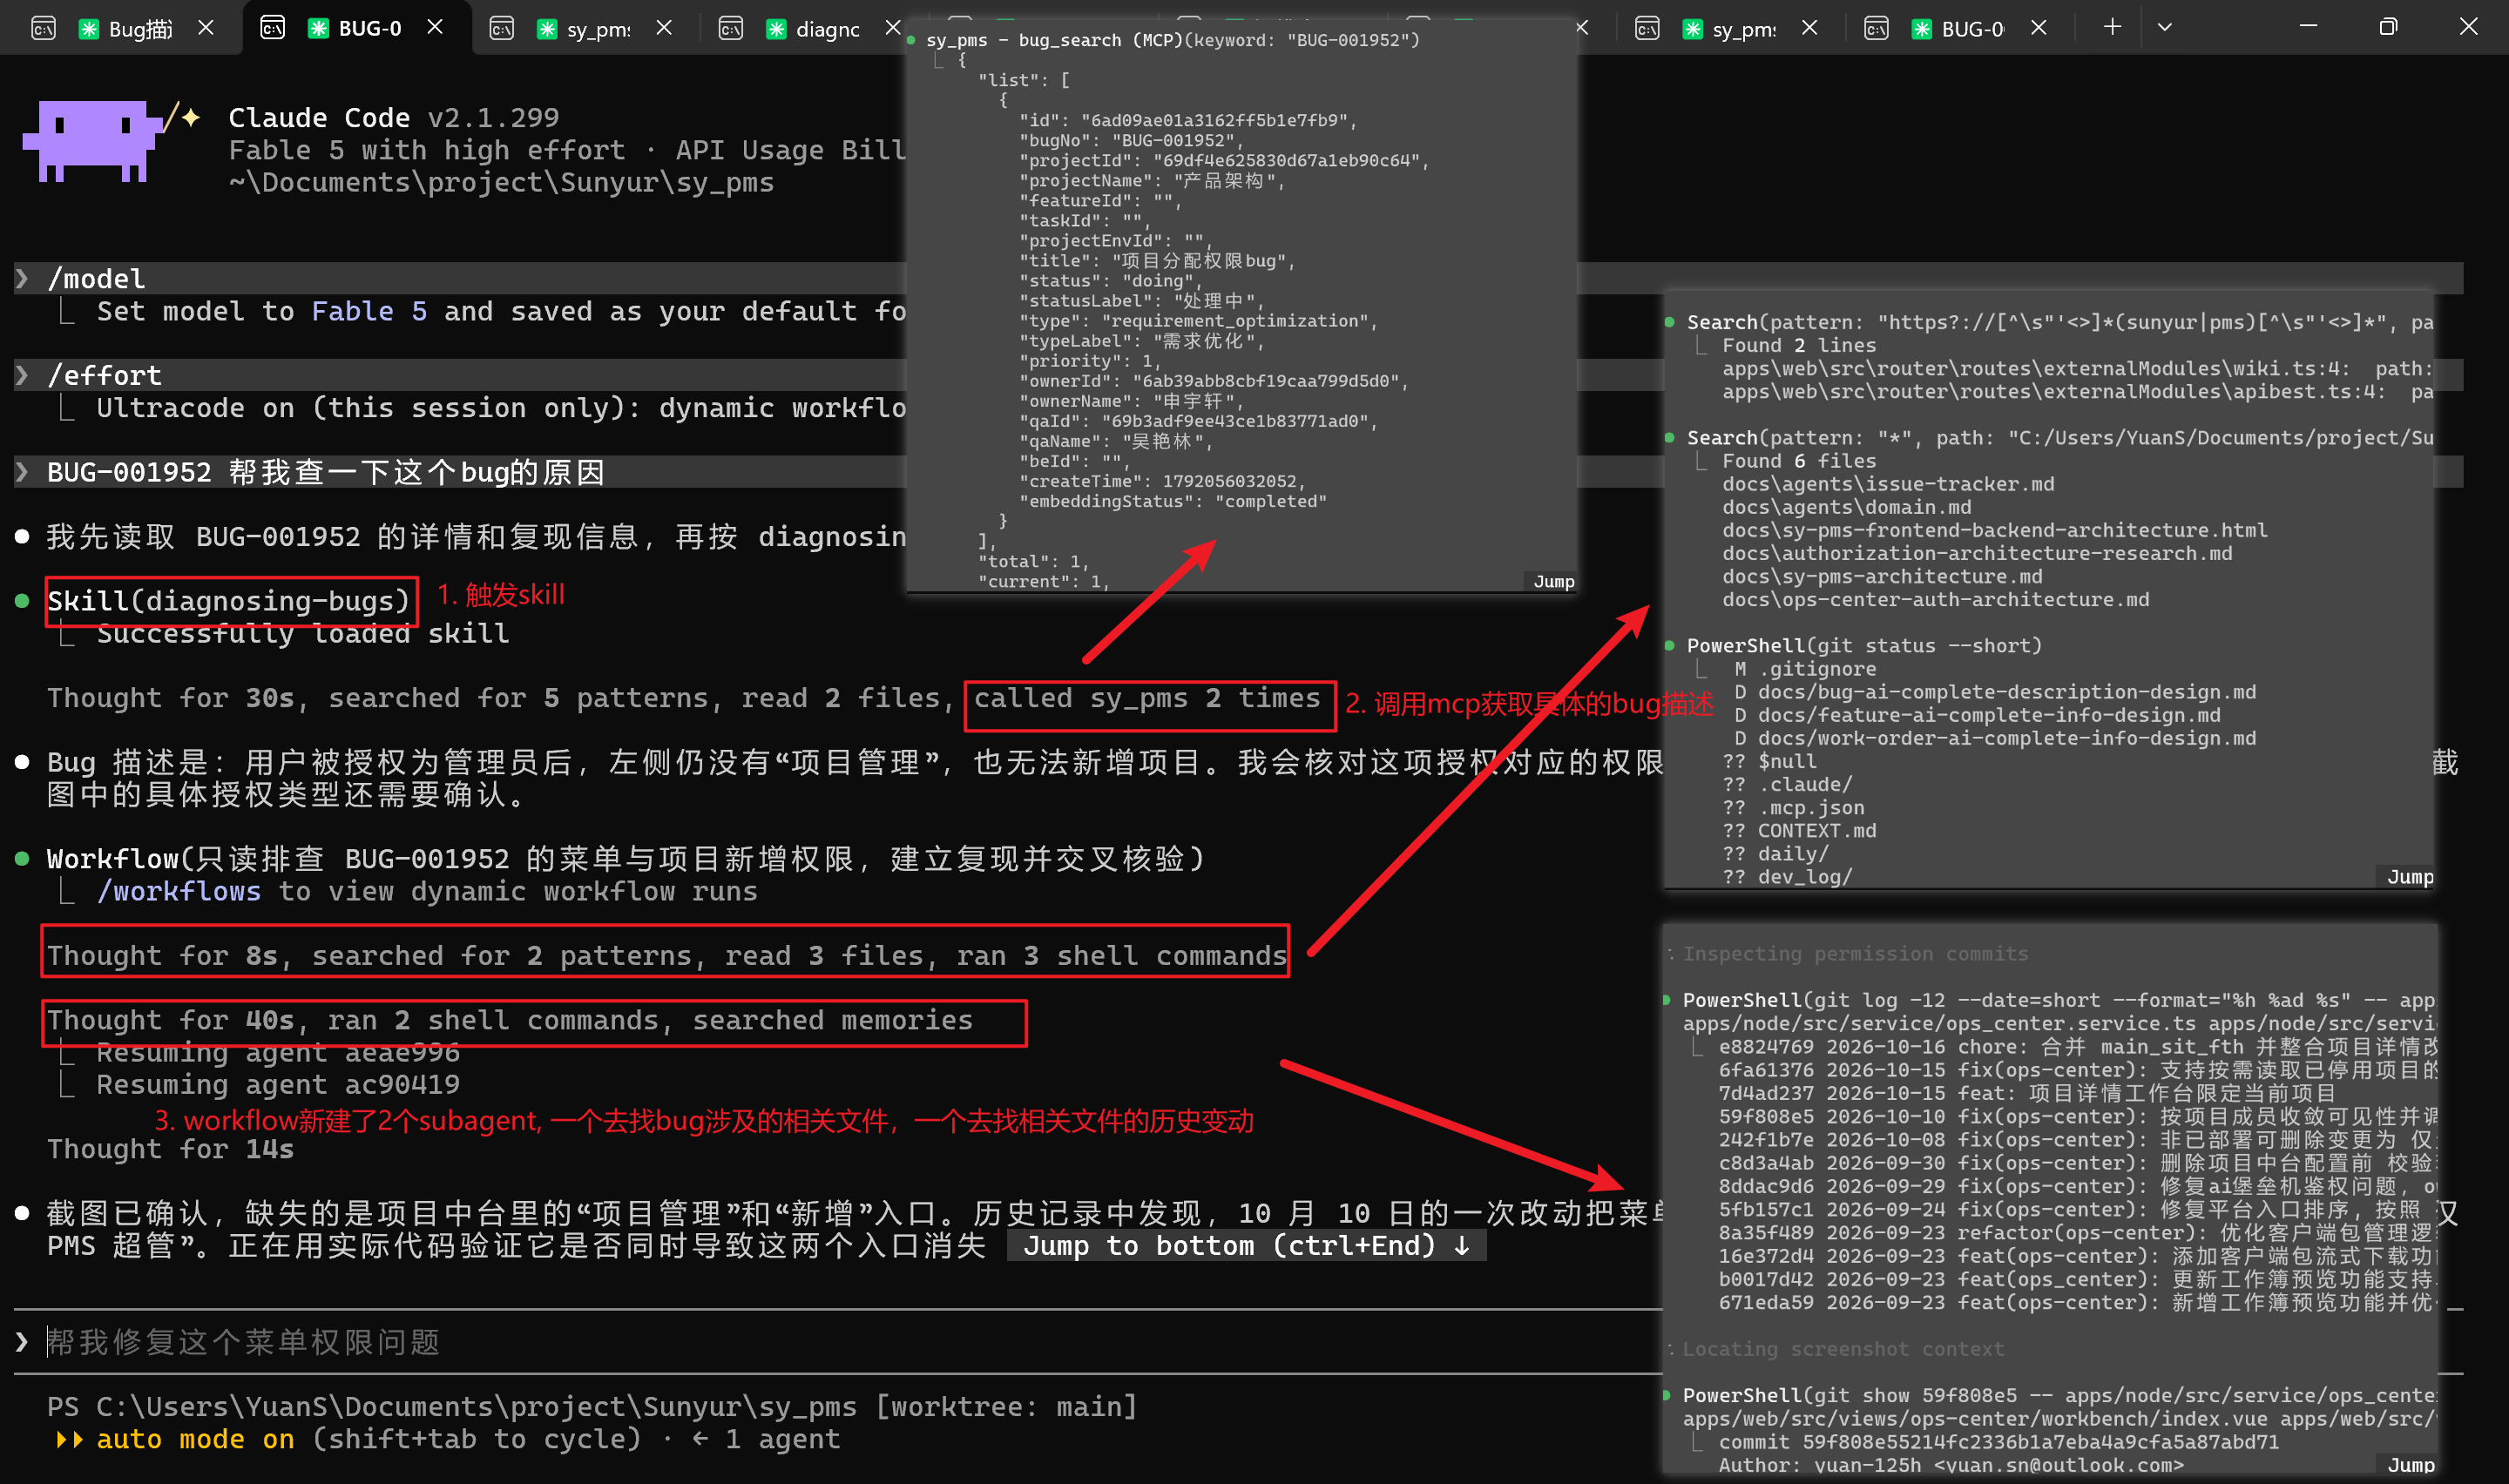
接着,workflow把排查任务拆给两个 subagent,一个找bug涉及的相关文件,另一个翻这些文件的历史改动。一个看现在,一个往回找,拿到的线索再交回来一起核对。这样,skill负责约束排查方法,MCP负责获取外部信息,subagent负责分头干活,各自的作用就比较清楚了。
构建反馈回路,继续验证
文件找到了,但读完代码总不能就算“查明白了”吧。接下来,agent围绕问题构建复现,通过实际运行拿到反馈,再顺着反馈继续排查。中间会等待后台任务返回,也会继续调用 subagent,把还没确认的部分单独拿出来验证。
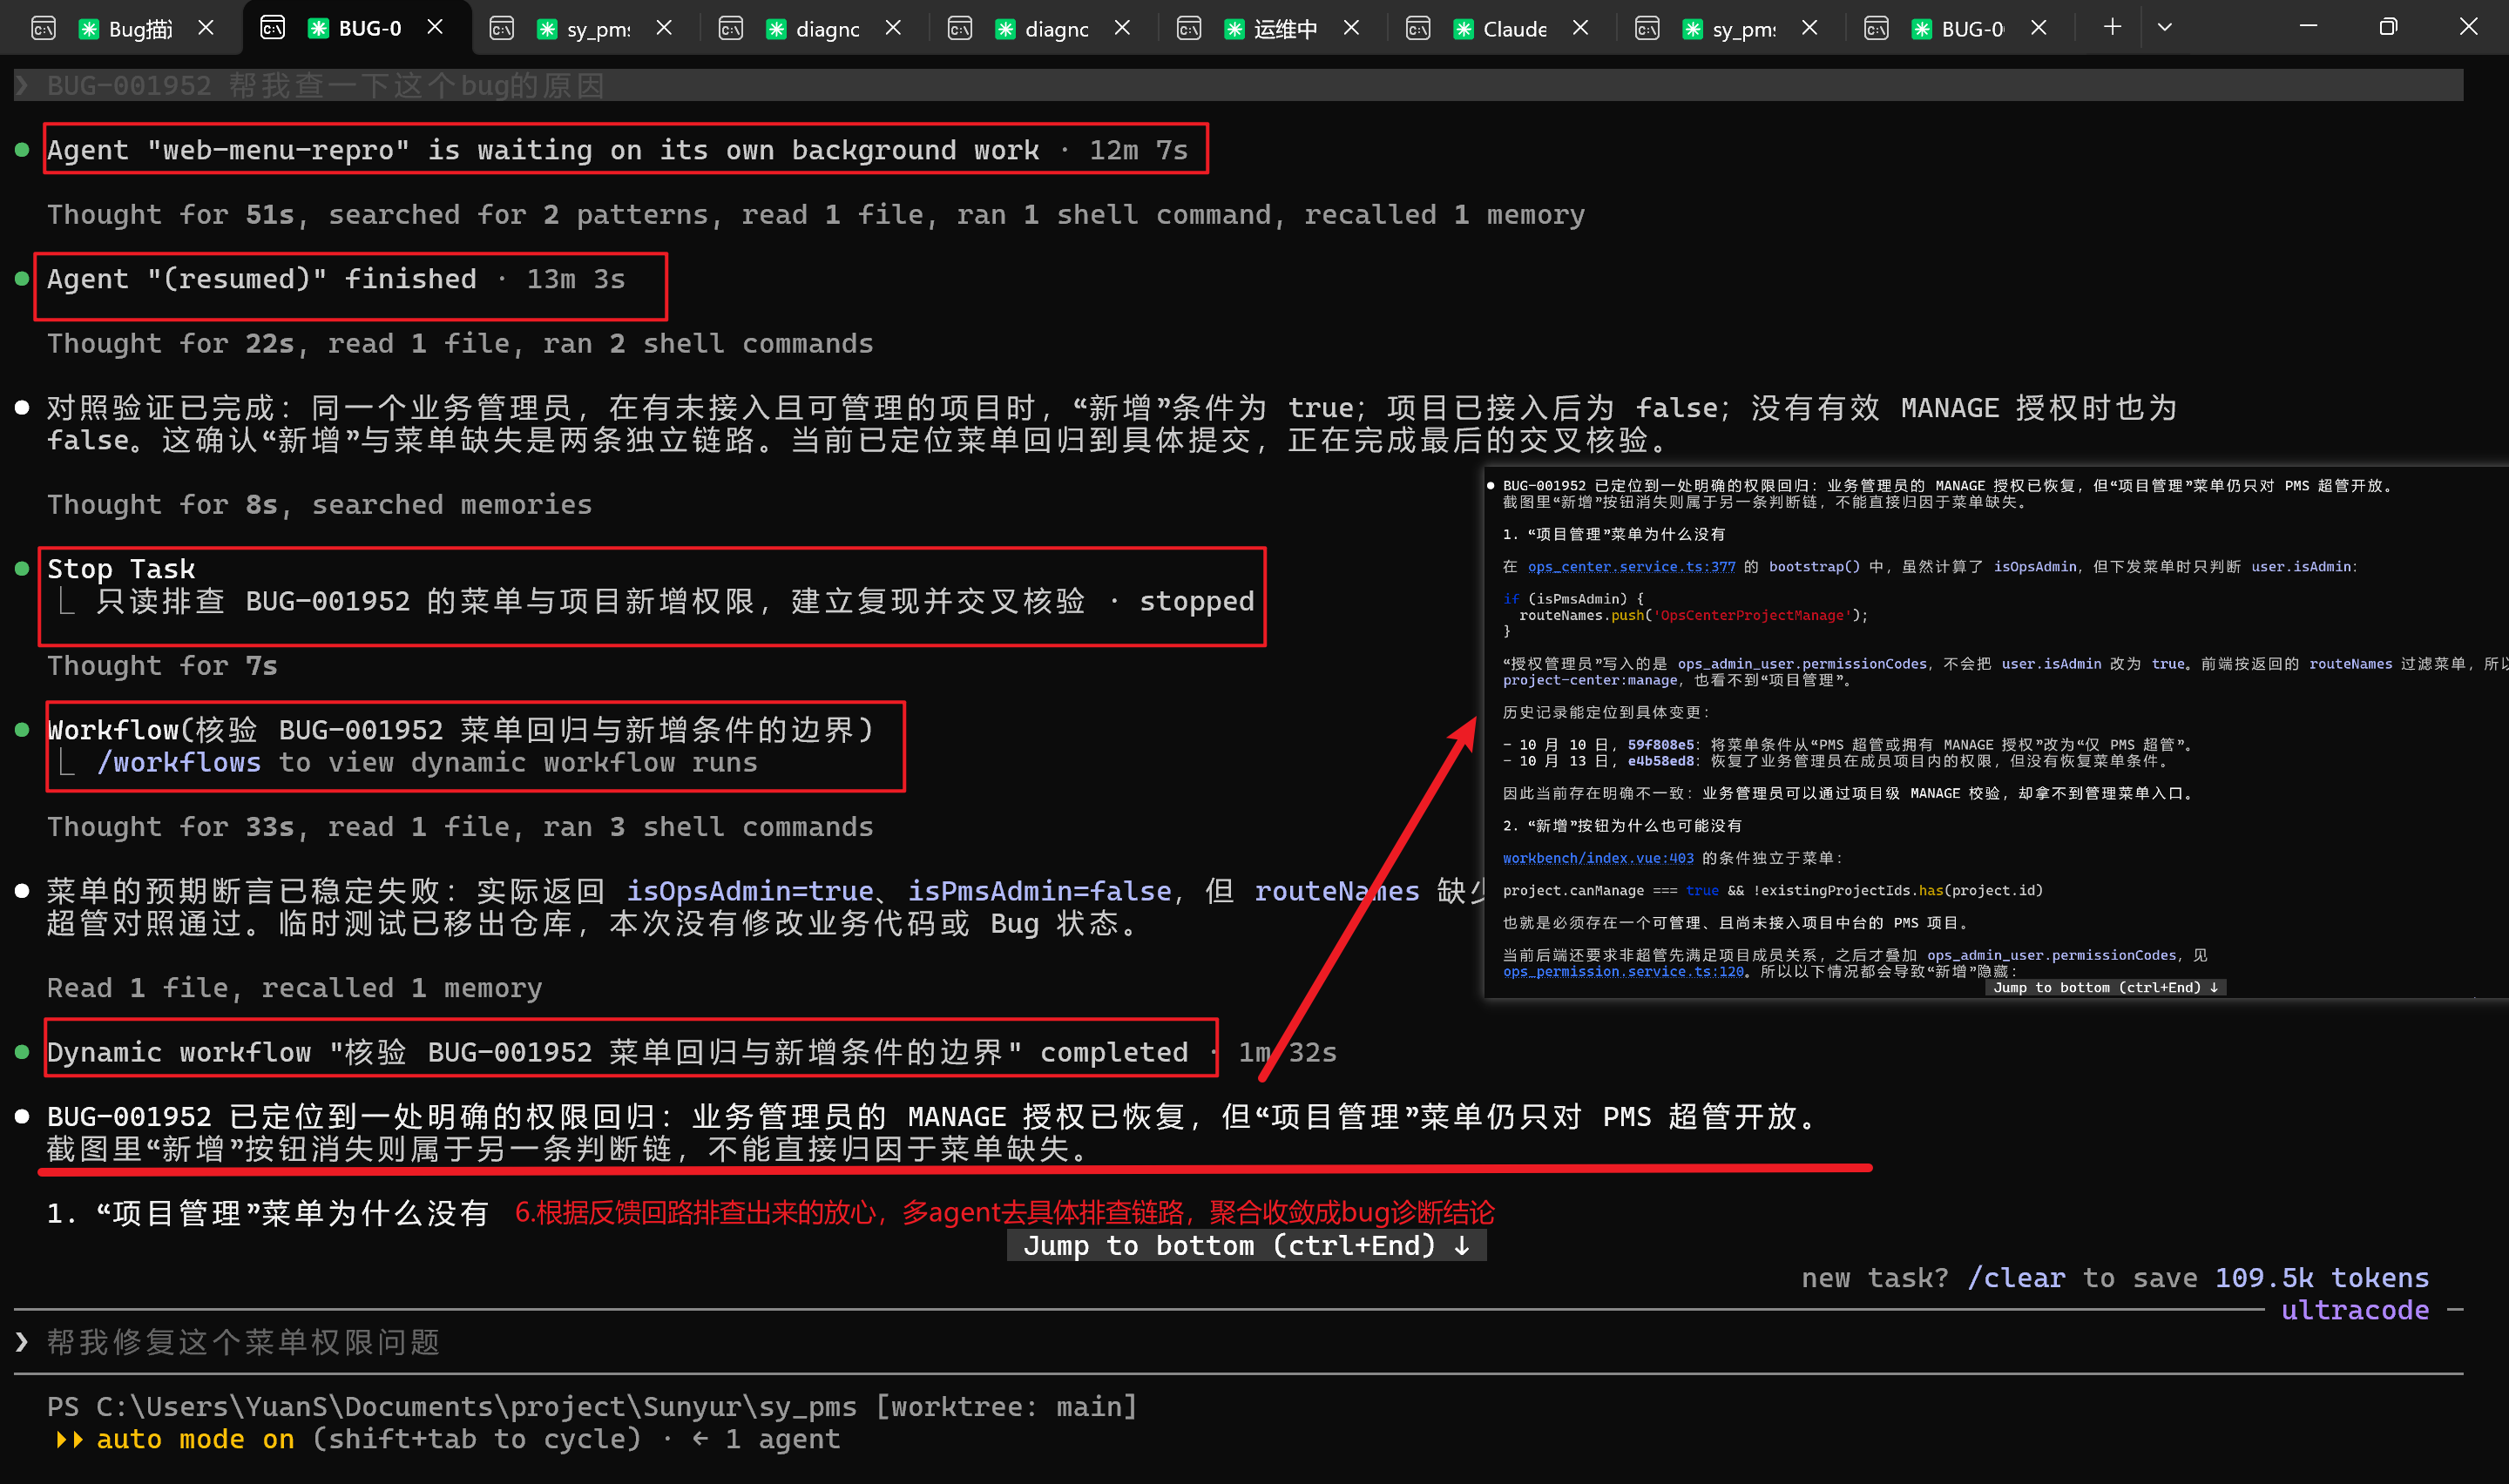
这里能看到,前一轮排查之后,又启动了一轮 workflow 做交叉核验。并不是某个agent说“找到了”,主agent就直接拿来当答案,而是把不同任务返回的信息放到一起,看看代码、历史改动和运行结果能不能对上。等这些核验完成,再整理出诊断结果,说明已经确认了什么、还有什么没确认。到这一步,业务代码还没有修改。
制定修复方案并执行
OK,原因查完,再叫agent去修复。进入 plan mode,先检查现有计划和测试结构,整理具体方案,给出具体的执行计划。
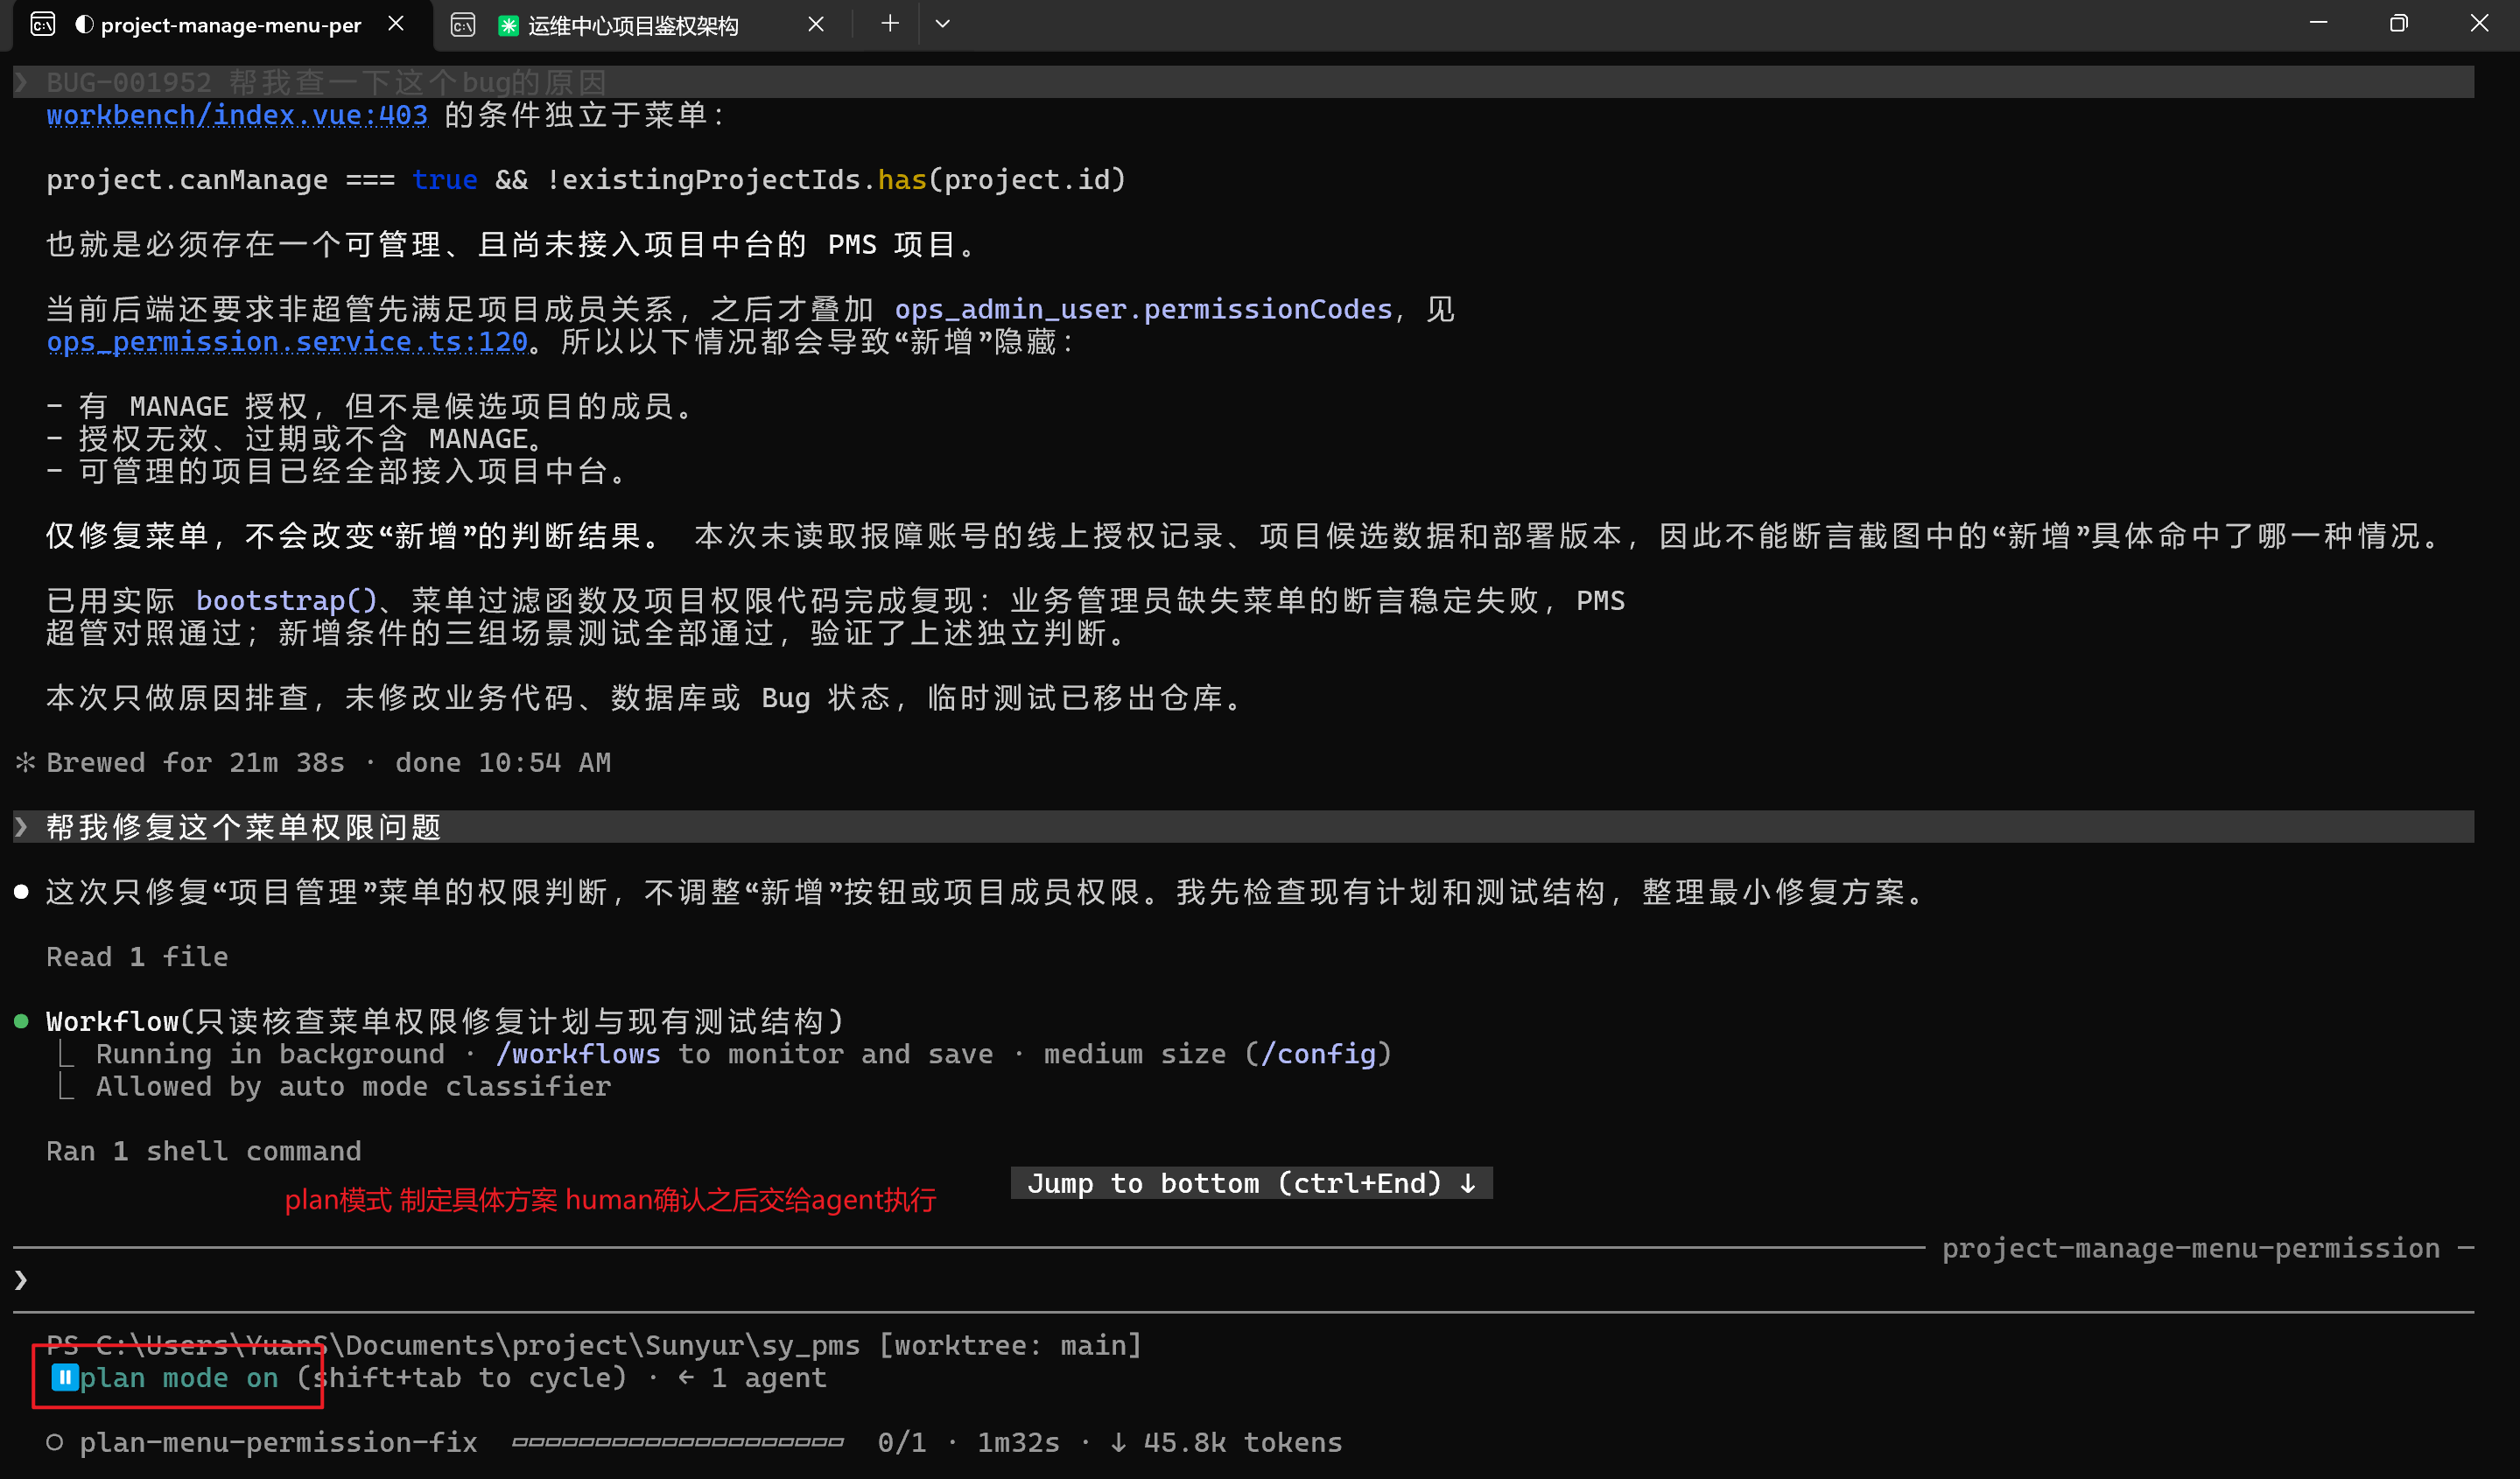
计划完成后human确认,agent执行,bug就完整改完了。